
梅塔的新前沿型号Muse Wonder Full加入了AI顶级.
在Active Memory和Active Focus的帮助下, Meta Muse Wonder Full以更强大的代理编码,数学和基准成绩跃升到边境AI地位, 但用户在任务和 tokens 之间面临更高的成本.
主要内容
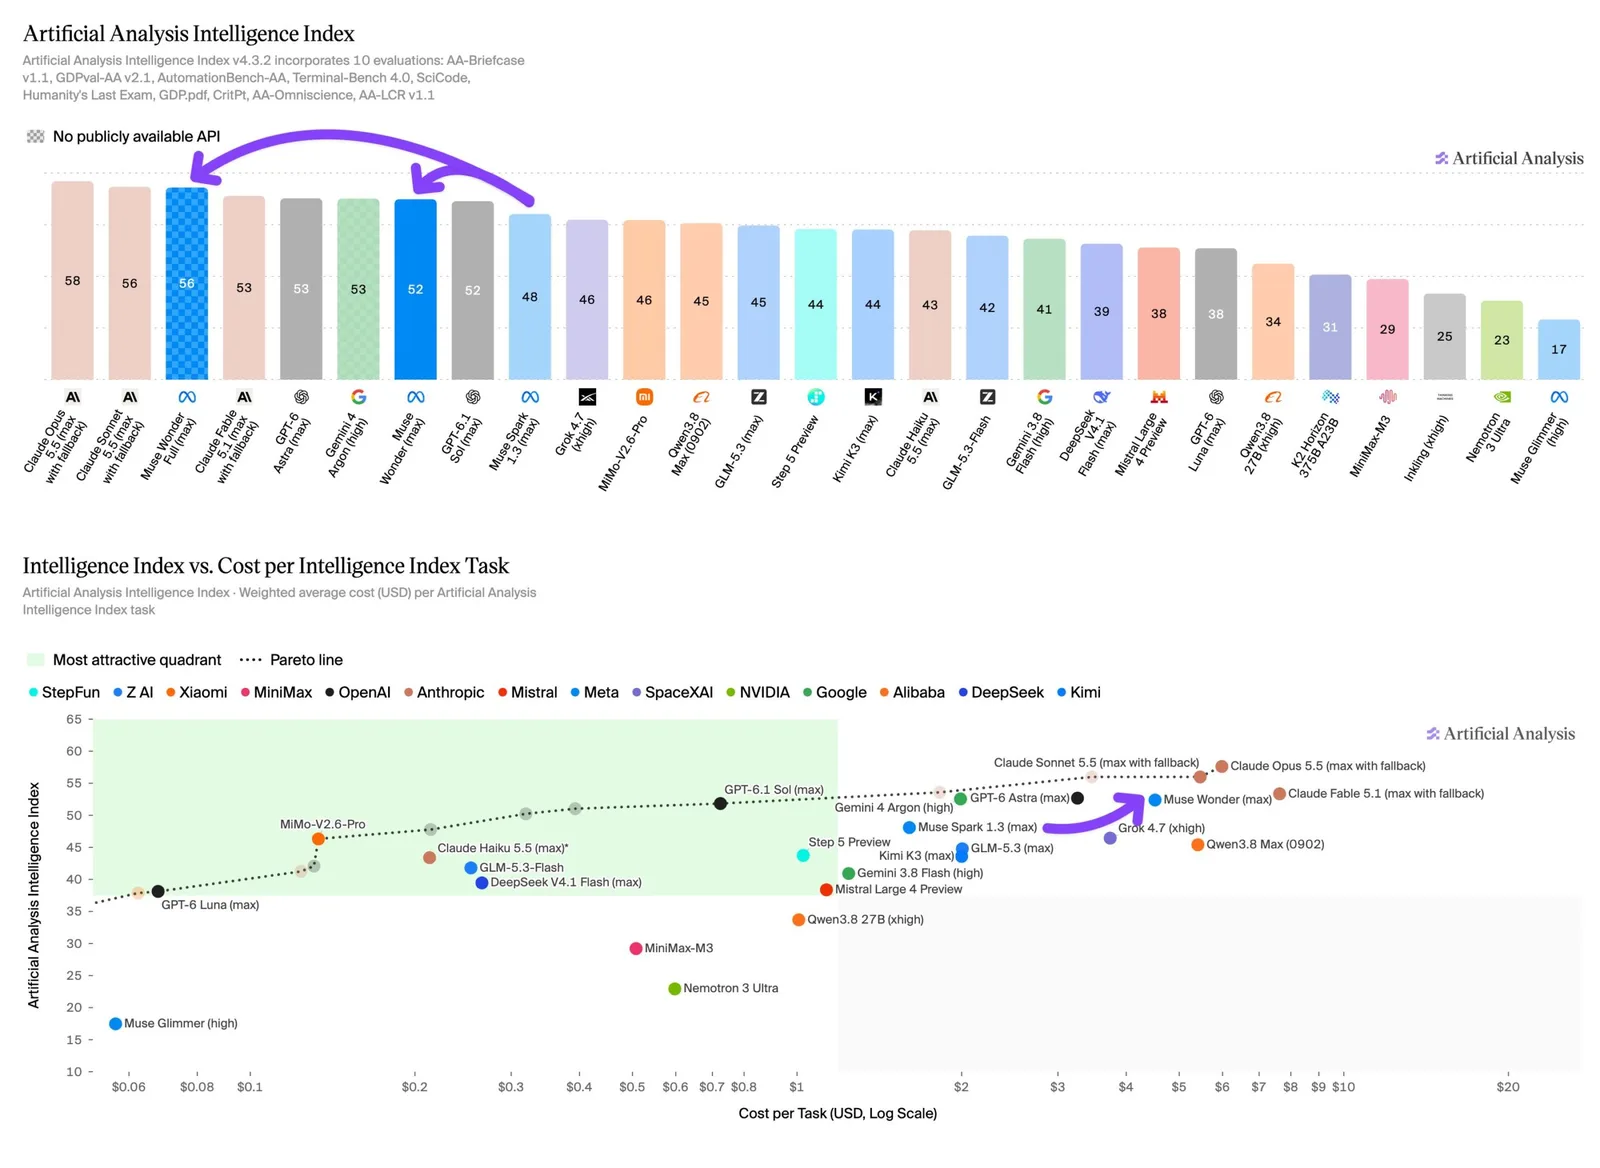
- Meta Muse Wonder 和 Muse Wonder Full 移动到边境 AI 层,在 Artificial Analysis Intelligence Index v4.3 上分为52和56,高于 Muse Spark 1.3 48.s 48.
- 在代理工作和编码方面出现了最大的改进,Terminal-Bench 4.0 和 Coding Agents Index,支持Meta.向个人 AI 代理推广.
- 模型添加了 Active Memory 和 Active Focus 以提高任务持久性和上下文回忆,但事实知识仍然是一个弱点,Muse Wonder Full在AA-全能中得分仅为30.
- 幻觉率有所提高,但性能却付出了更高的代价: Muse Wonder 每项任务成本约为 $4.52 , token 的定价明显高于其前身.
超级描述: Meta Muse Wonder 和 Muse Wonder Full 可以提高 AI 的基准分数,特别是代理编码,同时增加任务和 tokens 用户的成本.
标签: Meta Muse Wonder, AI 基准, 主体性 AI, 编码基准,3定价
!Abstract AI 基准网络和图表视觉对 Meta Muse Wonder](data:image/svg+ XML ,%3Csvg%20xmlns='http://www.w3.org/2000/svg '%20viewBox=' 0%200%201200%20675 '%3E%3Crect%20width=' 1200'%20height=' 675' %20fill='%230f172a'/%3e%3ccircle%20cx='180'% 20cy=' 180r='40' 20% fill='2338bdf8' /% 3E3%3Circle% 20cx ='250'% 30cf8'='420y='680p='60px='70px=20px=10px=120px=200px=150px=300px=100px=201px=189px=2020px=2000px=180px=250px=800px=350px=1200px'8'90px=140px=247'94"
推出了两种变体的前沿模式 Meta Muse Wonder,这使得两个模型都成为最好的 AI 型号之一. 在 Artificial Analysis Intelligence Index v4.3 Muse Wonder Full 上达到56分,而 Muse Wonder 记录52分. 前面 Muse Spark 1.3 记录48分,因此新版本将该系列从中层位置转移到前沿竞争中.对于在线广告公司来说,这是很重要的,因为收益集中在代理工作上,Meta正在推出一个可以访问日历,消息和文档的个人代理 AI.
背景:一个中级前身和较弱的开放式拉玛延伸
Meta Muse Wonder Muse Wonder Full 曾是Muse系列的参考点,其48分得分将它置于最突出的前沿系统以下.新的发布是在 Meta 与其开放式Llama模型相比较弱的一段时间之后进行的.这种背景使基准运动变得更加重要: AI 在十个基准中排在前三位,表明该公司已经赶上了领先的前沿模式而不是发表一个狭窄的结果.
Meta还在销售超越原始分数的功能. Active Memory让模型记住对话中的关键信息,并在需要时回忆它. Active Focus是模型坚持困难任务的能力,尝试替代方法,当某些事情不清楚的时候问后续问题. 这两种特性都支持公司个人 AI代理球场.
开发:代理收益,编码强度和数学进步. 应用程序
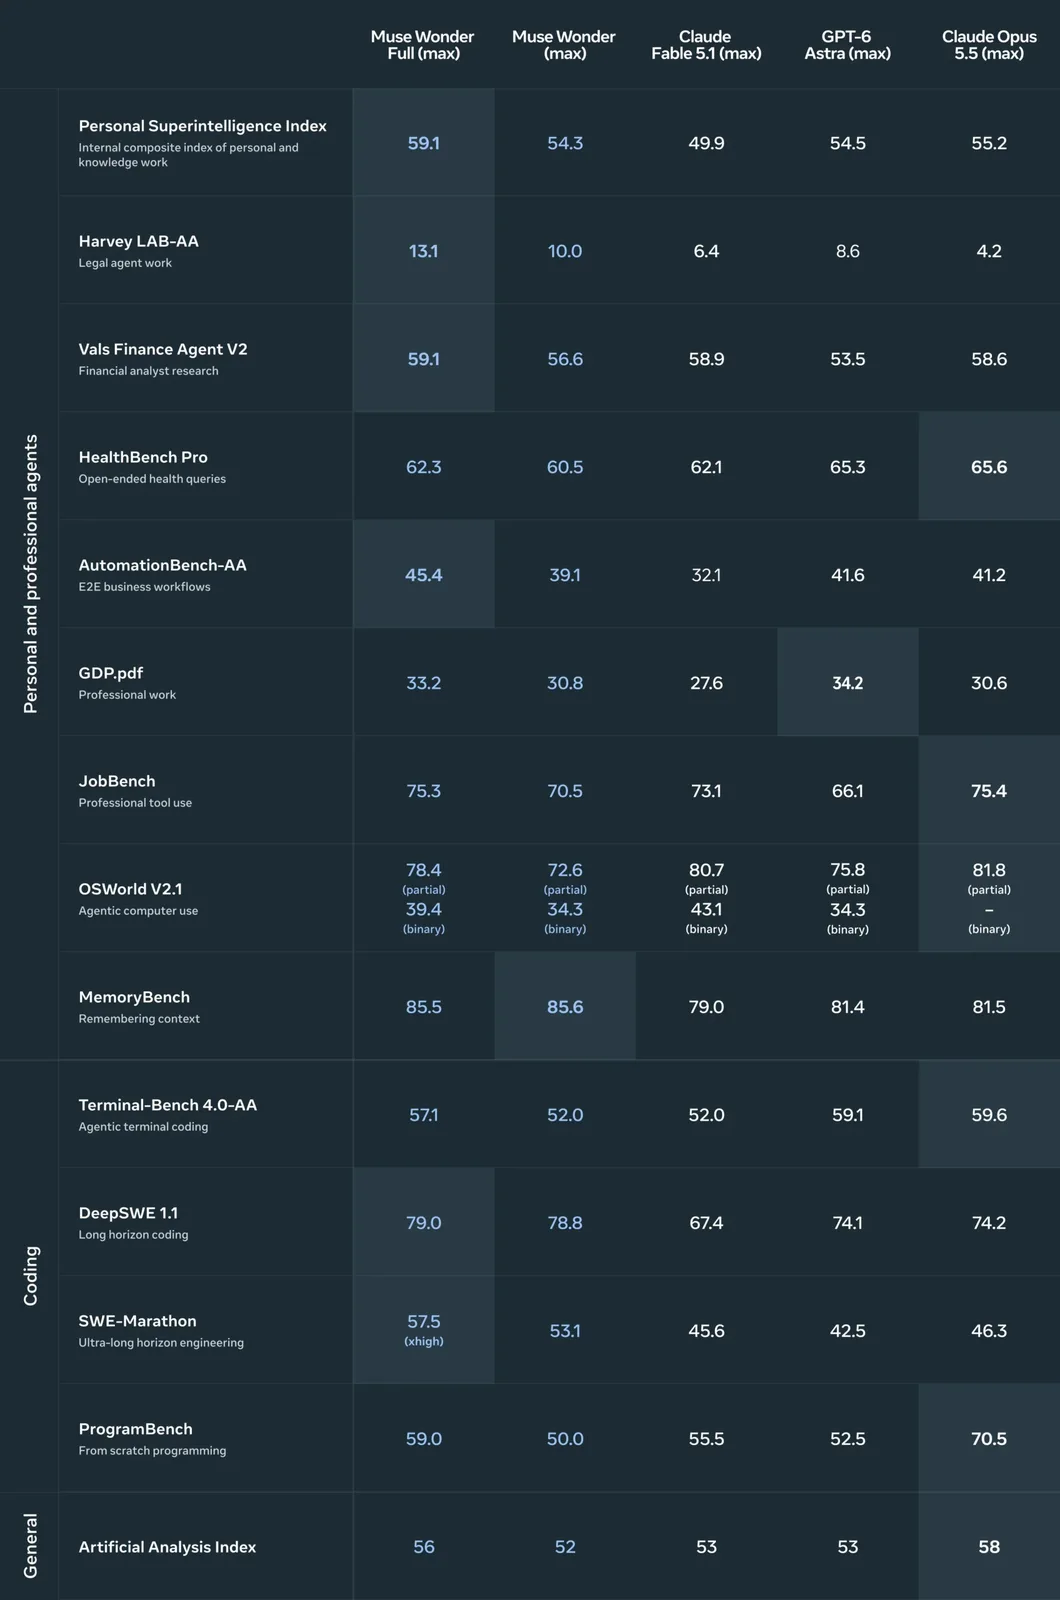
最大的改进出现在agentic评估中,测试衡量了 AI 模型能够自行处理复杂任务的程度.在Terminal-Bench 4.0,性能从33%跃升至57%.编码也急剧上升.Muse Wonder Full 在 Coding Agents Index 上达到68分,与 Sonnet 5.5 相匹配 Muse Wonder 得分63,高于其前身的54.
数学性能以类似的方式发生变化.在数学证明的私有基准ProofBench上,Muse Wonder Full它解决了100个问题中的94个,高于其前身的58.这使得 JUST 比99到100分的顶级模型落后五至六点.在Terminal-Bench4中,Muse Wonder Full它的评分翻了一倍,而使用30%更少的输出是 tokens .财务和法律任务的表现保持在之前的水平,下降到了两分.
根据 Vals AI, Muse Wonder Full (Max) 在第五位首次亮相并击败了所有 OpenAI 型号.只有当前的 Anthropic 型号得分更高.Muse Wonder在第十名.
梅塔在其博客文章中提出了一个常见的批评,称Muse模型被指责为基准调整但在现实世界中使用不足.该公司表示 Muse Wonder Full 在不熟悉的任务上做得比预期更好,而这些任务不是训练优化的一部分,并将其归功于一个更强大的基本模型.
最新进展:知识差距和更高的价格
事实知识仍然是最明显的弱点.在AA-万能的知识测试中,Muse Wonder Full只能获得30分,并且Muse Wonder得到25.这远远落后于Claude Opus 5.5 (46),GPT-6 Astra (43),和 Gemini 4 Argon (42),这表明Wonder系列基于比竞争对手更小的基本模型构建.
低幻觉率部分弥补了知识差距. Meta Muse Wonder 与前身相比,其幻觉速率从33%降至23%.这是所有至少获得45个指数点的模型中第二最低的.26] 4 Argon在15%,幻觉较少.
较好的性能也伴随着更高的成本.根据Artificial Analysis, Muse Wonder 在 Intelligence Index 上每任务运行 $4.52,几乎是 Muse Spark 1.3 的三倍,这使得每个任务的费用提高了 $1.60 . token 的定价也有所上升,每百万输入为 tokens 和 $20 ,而前者则是 $1.25和 $4.25.Muse Wonder 也使用 28% 的输入 tokens ,这些占总成本的 76%.
价格仍然低于Claude Fable 5.1 ($7.63) 和Claude Opus 5.5 ($5.98),但高于GPT-6 Astra (38), Gemini 4 Argon (39),和GPT-6.1 SOL (41). 目前还没有提供 token 的定价 Muse Wonder Full.这两款车型使用的输出量比其前减少了约10%.
目前阶段:强大的代理工具,但成本和知识仍然是开放的问题
它们的代理编码和数学收益表明为什么Meta将其定位为前沿模型.开放的问题更窄:是否 Active Memory 和 Active Focus 在基准条件之外提供可靠的代理行为,是否可以缩小AA-Omniscience差距,以及用户是否会在输出时吸收较高的input- token 成本 - token 使用下降约10%.
据Meta称,它在内部的Prometheus data center 以千兆瓦规模训练了模型.更多细节可以在模型卡上找到.目前来说,该版本标志着基准地位向前迈出的明确一步,而事实知识和定价仍然是最明显的限制.
Comments
No comments yet. Be the first to comment.