
呈现了它与弗林特的人工智能驱动研究过程中的第一个结果.
递归引入了Flint,它是通过Eureka Machine自动化研究过程构建的第一个公开发布模型.混合专家编码模型有40亿个总参数和 token 个活跃参数中的2.5亿个. 它针对本地代理编码进行优化,具有开放的Apache 2.0权重,支持常用运行时间以及为Apple Silicon和Nvidia GPUs定制内核. Flint测试人工智能驱动的研究是否可以改善未来的模型开发.
主要内容
- 递归发布了Flint,一个 40B参数混合专家的本地编码模型,每个代币有 2.5B 的活跃参数,作为其 Eureka Machine 自动化研究过程的第一个结果.
- Eureka Machine据报道塑造了主要的技术选择,包括模型架构,4位量子化与蒸和自定义推理内核 Apple Silicon 和 Nvidia RTX Spark.
- Flint 设计用于快速的,私有的设备内代理编码,在 Apache 2.0 中提供开放权重和支持常见本地运行时间如 llama.cpp , Ollama LM Studio, vLLM 和 SGLang .
- 与类似稀疏的模型相比,重复性声称具有强大的速度和编码基准结果,但这些发现没有得到独立验证,而复杂任务可能仍然需要更多的指导.
代码描述:回归式发布的Flint,一个40亿参数混合专家编码模型,拥有 2.5十亿个活跃参数,用 Eureka Machine 在四个月内构建.
标签:复制,石 Eureka Machine,本地编码模型,专家混合
主要图片:抽象的技术风格, 带有发光电路模式和神经网络节点.
递归的第一个语言模型Flint是在经过四个月的自动化研究之后发布的,这一发行值得注意,因为该初创公司表示其 Eureka Machine参与了几乎所有开发步骤:自己提出想法,构建它们,测试它们并根据结果规划后续实验. Flint是一个专家混合模式,旨在对代理编码进行设计,这意味着在本地硬件上编码任务,其中模型计划和执行步骤.它有40亿个总参数,每令牌有80亿个活跃参数.对于读者来说,当前的问题是本地编码辅助是否可以变得更快,更私密,而更大的问题是研究系统 AI能否真正改进下一款模型.
在发布之前:隐蔽,资金和研究注. (图片来源)
创业公司Recursive于2010年5月10日成立,并以13亿美元的估值筹集了100万美元资金.当时没有具体的技术成果可供展示. Recursive正在做出一项注:它希望构建持续改进系统的系统.它的长期目标是不断提高自身的超级智能,每个新模型都应该使研究人员变得更好,以便后来的模型可以更快更高效地建立.最终,该公司希望应用同样的方法来自动化其他科学领域的研究.Flint是该公司第一个公开提供的自动研究过程中的模型.
在四个月的构建中: Eureka Machine 形状架构,量子化和内核
根据Recursive,Eureka Machine处理整个研究循环并同时探索几种方法.在Flint项目中,它致力于训练数据,优化器,架构设计和推理调整. Recursive认为系统独立地选择了架构,量子化和计算内核,并且指出了三个例子.
起始架构使用了35亿个总参数和30亿个活跃参数.然后尝试不同的专家配置,Recursive说最终的设计,40亿个全参数与80亿个活动参数,在测试变体中提供了最佳速度和编码性能平衡.
在量子化 (使用较低精度权重的过程) 中,该系统通过将输出层降至四位也打破了常规做法.添加了一个蒸.步骤以恢复由于更低精确度而失去的准确性,Recursive表示它需要与以前方法相比训练步骤大约为一半.根据 Recursive 的说法,完成的 NVFP4 模型在基准测试中仅落后于 16 比特版本 0.7 点.
该系统还为 Apple Silicon 和 Nvidia RTX Spark 创建了专门的计算内核.在果M4和 M5芯片上,金属大核心将代币生成过程中的全向传输合并到一个操作中.递归式将高推理速度归因于跨越多个开发阶段进行的优化.
释放细节:本地编码速度,开放重量和限制
语境窗口,即一次处理的文本数量可以达到 512,000 个令牌,但Recursive 建议限制为 256,000 条.权重是在 Apache 2.0 许可证下发布的,支持的运行时间包括 llama.cpp , Ollama LM Studio, vLLM 和 SGLang .该公司还引入了 rec ,这是一个用于 Apple Silicon 的推理引擎.
实际后果是代码可以在设备上处理,而不是发送到外部服务器.递归式承认复杂的任务可能需要比大型专有编码模型更多的指导,并建议将更大的工作分成较小的步骤.
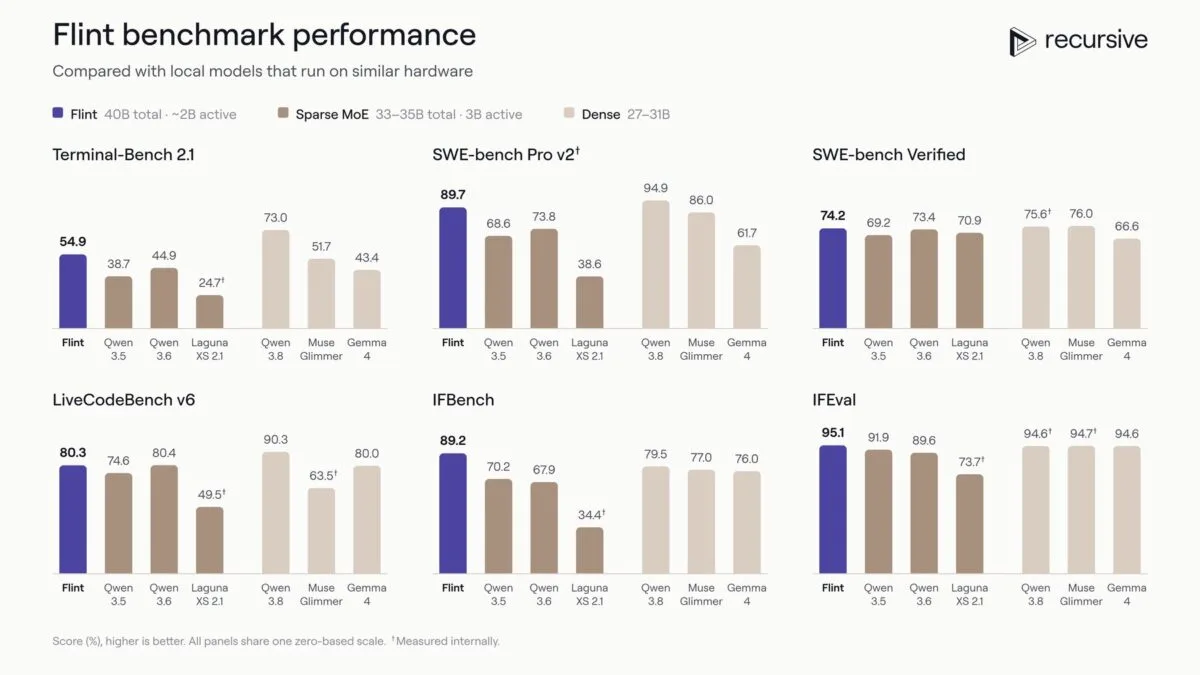
在基准声明中,Recursive表示Flint领先于其他混合专家模型的参数不到500亿个,例如Qwen3.6-35B-A3B和Laguna S 2.1,SWE-Bench Pro v2,Terminal-Bench 2.1 和SWE-2.Bench Verified 结果尚未得到独立验证.
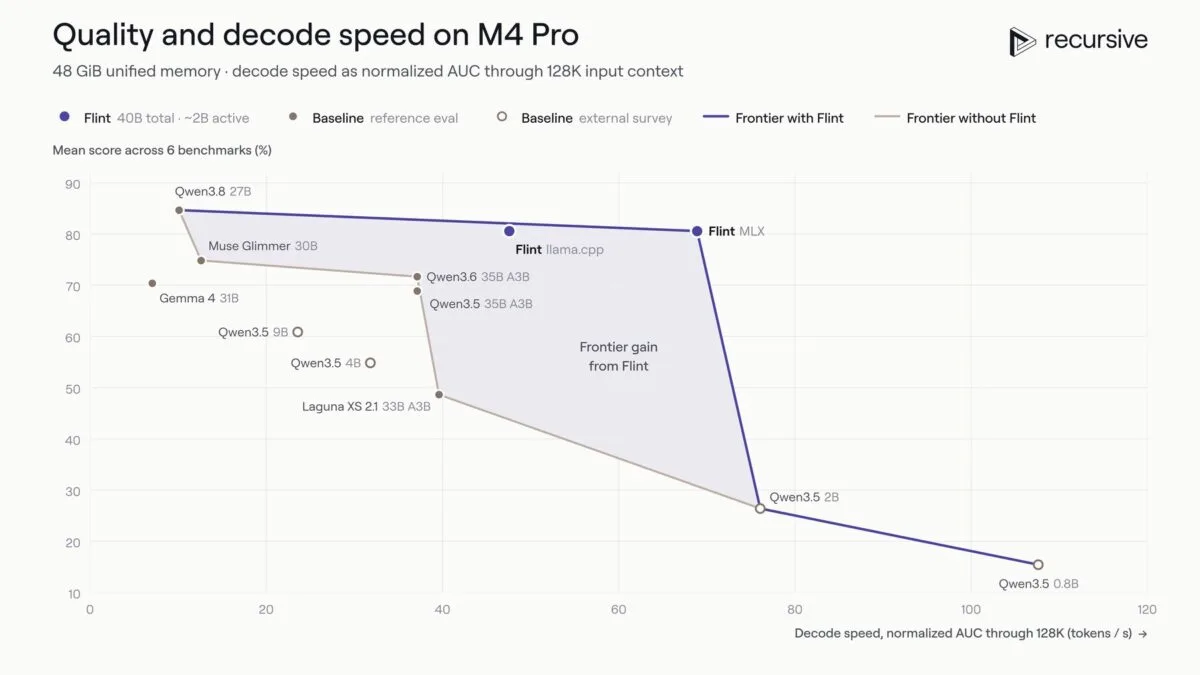
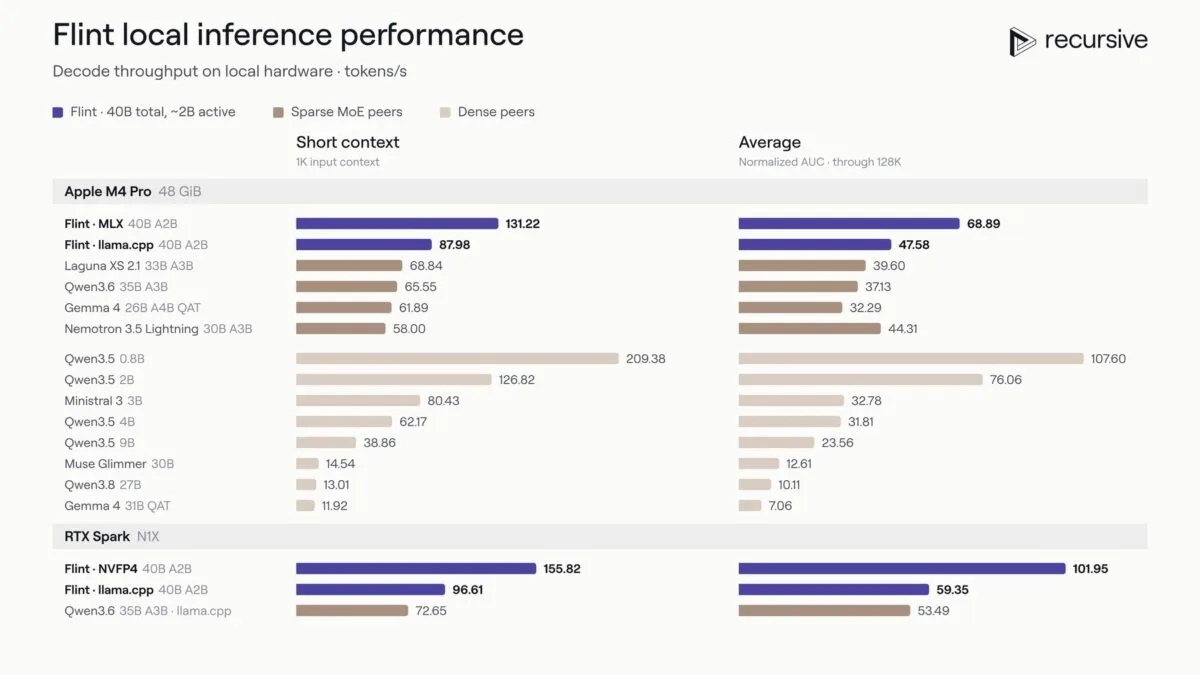
递归式说一个48 GB M4 Pro可以达到基准得分类似于更慢的密集型模型,激活每个令牌的所有参数,在27到31亿个参数范围内. 回转性定位弗林特对25至40亿个參數范围内的密集模型而运行超过五倍快.对于具有MacBook Pro 的M4 Pro,回归式报告短环境下每秒超过125个令牌; 在内存有64 GB 的Nvidia RTX Spark,它达到了每秒150个令币. 与相似模型相比,Recursive表示推理速度可高出两倍. Recursive发布的图表显示,在短背景长度上的同等 context合-专家模型中的每秒代码大约是2倍. 该公司称Flint在所有六种编码和指导遵循中都领先于稀疏混合-专业模型之间的基准,尽管一些类似的大小模块 (如Qwen) 在测试中得分较高.3.8
索赔现状
目前尚不清楚这条路径是否会产生加速的自我改进. 40B实验室也在模型开发中使用 AI .人类学报告称,克劳德现在已经完成了大量自己的开发工作,而OpenAI则在其整个研究管道上部署了 AI 代理人.自动化到底有多远仍然存在争议.一项涵盖700多个任务日志的研究发现 AI,代理人执行很大一部分的工作,但人类仍做出大多数关键研究调用.
Oriol Vinyals,前Google DeepMind研究负责人,认为人工智能辅助的自我改进是现实的,但认为情报爆炸不太可能发生.产生良好的研究想法和可靠地判断结果对AI系统来说尤其困难.这些都是Recursive希望自动化的步骤 Eureka Machine.
弗林特是第一个具体的结果,但它还没有证明完全递归自我改进.这将需要表明由 Eureka Machine 生产的模型使得 Eureka Machine 自己成为更好的研究人员.因此当前阶段是一个早期信号:通过自动化架构搜索,定量和硬件特定内核,本地代理编码可能会变得更加实用,而基准要求仍在等待独立验证.
Comments
No comments yet. Be the first to comment.