
QwenGyre:一个动态可扩展的 reinforcement learning 框架,用于训练xLong-Horizon代理人
QwenGyre通过弹性GPU重新分配和轨迹复制提升了长视野在线RL,将NL2RepoBench提高到58.5%.
主要内容
- QwenGyre是一个端到端的极长时间在线 reinforcement learning 框架, 旨在减少GPU浪费和训练冗余的大型代理工作流程.
- 它的核心创新是弹性GPU重新分配,允许计算能力在推出和培训之间转移而不会中断长期执行.
- 一个轨迹 processor 重建分支历史,得分部分进展,并去复制冗余路径以使训练信号更有效和结构化.
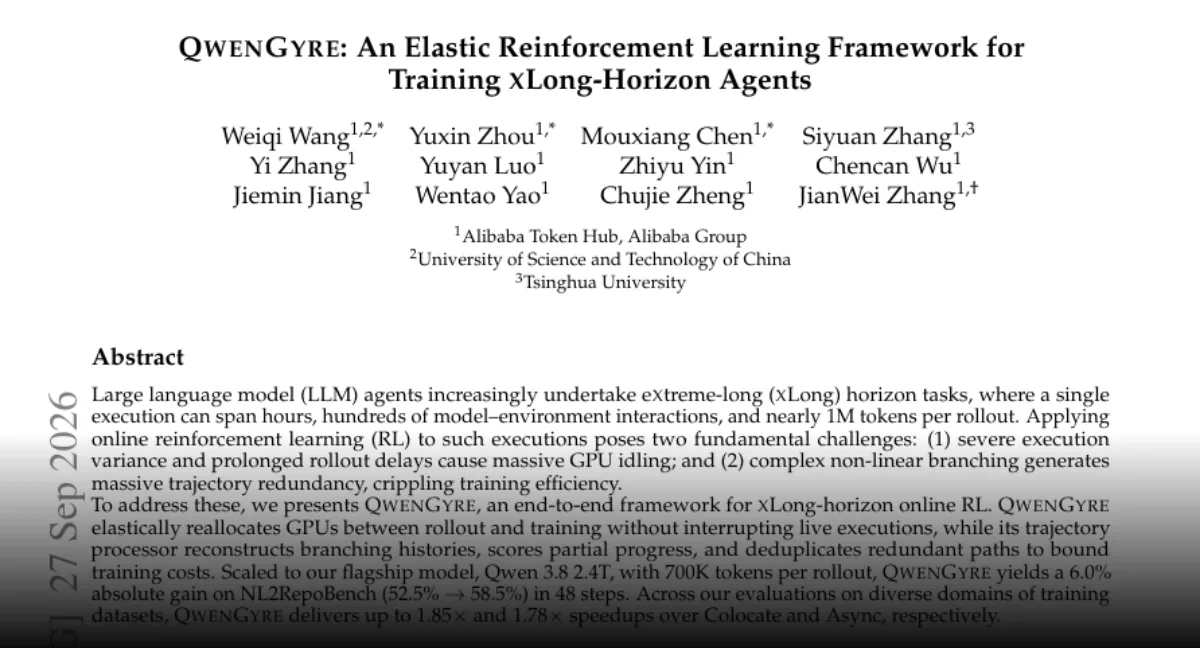
- 在 Qwen -3.8和2.4T上,QwenGyre将NL2RepoBench在48个步骤中从52.5%改进到58.5%,报告速度比Colocate快1.85倍,而比Async快1.78倍.
简介:QwenGyre针对长视野在线RL,弹性地重新分配 GPUs 并删除重复轨迹,同时将NL2RepoBench从52.5%提升到58.5%.
标签:QwenGyre,在线 reinforcement learning ,长视野的代理人,89000调度,NL2RepoBench
特色图像:抽象的技术风格图形,流动GPU分配曲线,分支轨迹树和基准进度线,没有人,标志或文本.
large language model (LLM) 代理越来越多地承担极长的 (xlong) 地平线任务,其中一个执行可以跨度数小时,数百个模型环境交互和每次部署近1M. QwenGyre是一个端到端框架 xlong-horizon在线 reinforcement learning (RL),引入以减少这些执行所造成的GPU浪费和培训冗余. 该框架扩展至旗舰型号 Qwen 3.8 2.4T,每个部署有700K tokens ,并在48步中获得NL2ReBenpoch (52.5% → 58.5%) 的绝对收益.
背景:长视野的RL在哪里崩
从短提示到代理工作流的转变改变了培训瓶. 一次推出不再是简短的交换; 它可以跨越数小时和数百个模型环境互动. 这种规模使在线 reinforcement learning 难以两种基本方式.
首先,严重的执行差异和长时间的推出延迟导致GPU次大规模置.当某些轨迹比其他轨道需要更长时间时,计算资源可以花费时间等待而不是推进模型更新.其次,复杂的非线性分支会产生大量的轨迹冗余,削弱训练效率.随着代理人通过环境探索许多可能的路径,重复或重叠的历史记录可以膨胀每个训练步骤所需的工作量.
发展: Elastic GPU控制和轨道重建
QwenGyre 通过将部署和培训视为可以在实时执行过程中重新平衡的资源来做出反应.其核心机制可弹性地重新分配 GPUs 在部署与培训之间,而不会打断现场执行.这意味着系统不需要停止长轨迹以向当前受限制的工作负载的一侧转移容量.
框架的第二部分是 processor 轨迹.它重建了分支历史,得分部分进度,并将冗余路径去复制为绑定训练成本.在实践中,这使长视野探索的混乱输出变成了一个更结构化的训练信号.而不是把每一个重复的分支带入更新循环中, reinforcement learning 4可以识别哪些部分路径很重要,哪些是多余的.
最新的进展: 700K- token 推出和基准收益
在NL2RepoBench上,QwenGyre产生了6.0%的绝对收益,在48个步骤中将得分从52.5%移动到58.5%.
在对不同培训领域的评估中 datasets ,QwenGyre比Colocate和Async分别提高了1.85倍和1.78倍.这些比较表明,该框架的价值不仅限于单个基准结果;它还旨在减少培训循环本身的时间和资源成本.
当前阶段:数字表明
结果将QwenGyre定位为应对代理培训中的特定基础设施问题:长时间执行可能会阻碍GPU的利用,分支轨迹可以使更新变得昂贵.报告的700K- token 推出设置和48步NL2RepoBench增益表明该方法可用于 large model ,同时产生可测量的基准性能改善.
还有待观察的是,当任务接近后台描述的近1M- token 每次部署上限时,同样的弹性GPU重新分配和轨迹重建如何表现.与Colocate和Async相比,加快速度也表明了一个更广泛的培训系统问题:QwenGyre是否可以在不中断实时执行的情况下保持更多领域和较长时间内提高效率?
Comments
No comments yet. Be the first to comment.