
ColNanoVDR:为多向量视觉文档检索提供最佳基于传输的无文件查询蒸
ColNanoVDR将4.5B-8.8B多向量视觉检索器蒸.成一个仅为文本的查询编码器149M,保持93 - 96%教师NDCG@5而不需要重新索引.
关键点
- ColNanoVDR将89000089890001参数的大型多向量视觉文档检索器压缩成一个仅为文字的查询编码器149M.
- 它使用Optimal Transport和Learned Weights将学生查询 tokens 与教师 tokens ,而不是在训练期间阅读文档页面.
- 提炼的学生将查询与老师现有的页面索引进行比较, 不需要重新索引并降低部署成本.
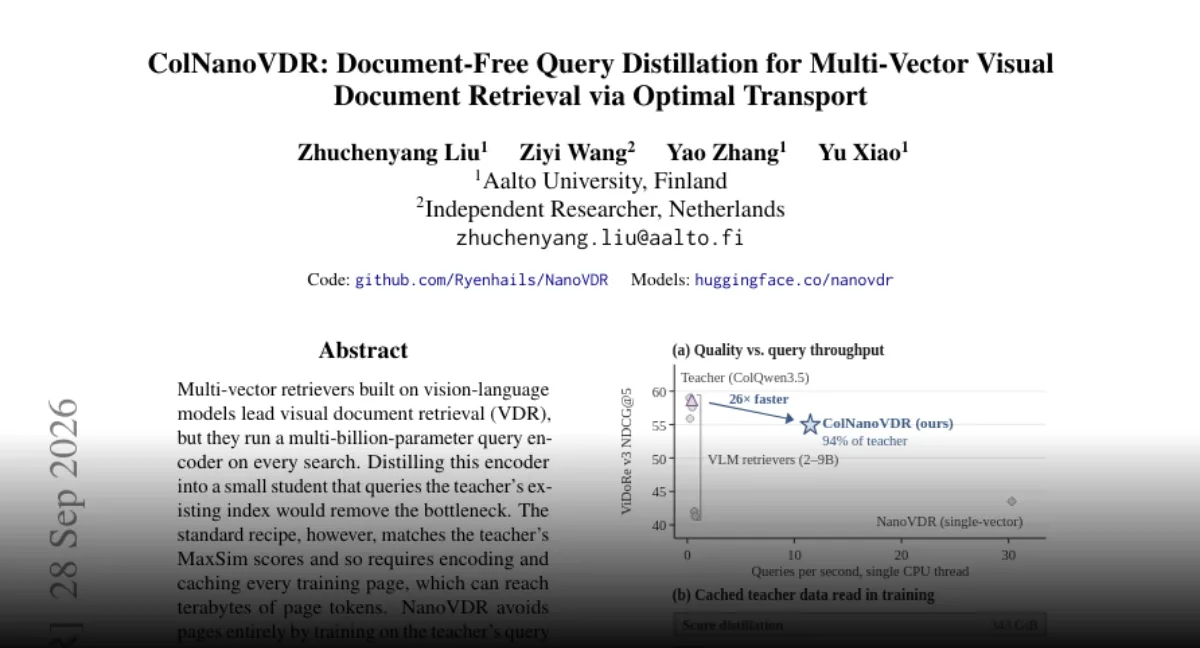
- 在 ViDoRe v3 上,ColNanoVDR 保留了 5 名教师的 89000589890006 的 NDCG@5,同时在单个 CPU 线程上进行查询编码速度高达 26 倍.
- 已公布的代码和检查点表明,多向量视觉检索可以有效地使用一个小的纯文本编码器,同时保留教师指数.
标签描述: 字体的类型是什么? (Meta description) ColNanoVDR将 89000089890001 多向量视觉文档检索器压缩成一个仅为文字的查询编码器,达到教师 NDCG@5 的 93 89 96%,而无需重新索引.
标签: 一个字母,一个字符号. (TG) " 视觉文档检索,知识提炼,多向量检索
纳米VDR背后的研究人员已将无文档蒸.扩展到多向量视觉文件检索,使用一种名为ColNanoVDR的方法.该工作压缩了从4.5B至8.8B参数范围内的数十亿参数多向量的视觉语言模型 (VLM) 检索器,进入一个单一的149M纯文字查询编码器中.学生编码者直接对教师现有的页面索引进行分数查询,因此不需要重新索引.
背景:为什么多向量检索是昂贵的
多向量检索表示文件多为 token 级向量而不是一个 embedding ,这提高了排名质量,但增加了存储和计算成本.视觉文档检索添加了一个层:页面被大型VLM作为图像处理,使查询编码缓慢且资源繁重.NanoVDR先前表明无文档蒸.可以缩小单向量的检索器.ColNanoVIDR适用于更难的多向量设置相同原则.
蒸的运作方式
核心组件是OTW,简称Optimal Transport和Learned Weights. OTW将学生的查询 tokens 与老师的 tokens ,这意味着培训从来没有读过页面.因为学生只编码文本查询并对其进行分数教师缓存的页面索引,部署避免重建索引.
五位教师的研究结果
在ViDoRe v3中,蒸.的学生保留了他们的老师NDCG@5中的93.0 89 96.0%,与ColVec1.1-8b配对时最好的配置达到了60.1.查询编码在单个CPU线程上运行速度快26倍.该方法还匹配得分蒸.,同时读取12.6×更少缓存的教师数据.
需要注意什么
代码可在github.com/Ryenhails/NanoVDR,所有五名学生的检查点发布于huggingface.co/nanovdr.结果表明,多向量视觉检索可以使用一个小的仅文本编码器同时保持教师的指数完好无损,这种组合既降低了延迟和基础设施成本.下一个问题是这个没有文件的方法如何扩展到比ViDoRe v3更大的老师和更广泛的基准.
Comments
No comments yet. Be the first to comment.