深度基准:量化剩余连接如何促进更大的计算深度
在固定的尺寸和训练下进行DeepthBench测试10 Transformers 时,只有当剩余设计和规范化设计保持计算时才能显示深度.

重要机器学习论文,总结没有术语.
在固定的尺寸和训练下进行DeepthBench测试10 Transformers 时,只有当剩余设计和规范化设计保持计算时才能显示深度.
在LLM的推理中,EAPO使用来分配代币信用,惩罚自信失败,奖励不确定的成功,并保持复苏.
FlyBy通过将执行和知识瓶分开,并使用选择性的外部查询来帮助小推理模型保持准确的推理.
该论文通过使用在政策上的自蒸.来训练 token 模型以保持稀疏视觉输入的有用性,解决了极端的视觉 multimodal 2减少问题.它将 multimodal 2损失作为一个学习问题,旨在在攻击性的视觉压缩下保留语言接地和准确度.
通过结构化图像记录和程序计算的答案,VQS减少了VLM标签噪声,在10个基准值上提高了Qwen3-VL高达3.18分.
CIS 修复了 LLM RL 的训练-推断不匹配与自信意识的重要性抽样,提高 MoE 数学推理准确度.
Physical Coding 将 robot 个任务结构化为代码,通过Harness反和策略循环将HexaAnything的RoboCasa365成功提升到 XR -1 VLA.
SpatialSpeak是一个4B-参数视觉语言框架,旨在跨多个视图进行空间 chain-of-thought 推理.它首先通过QA原生重建来学习本地几何和全球场景上下文,将场景表示与问题答案监督联系起来.然后该模型逐步执行空间推理并应用视觉补偿以使用图像证据验证和纠正答案.这种…
通过难度匹配的提示和标题奖励,AdaTutoRank提高了 RAG 重新排名.
嵌入式存储器 (EmbodiedMemory-Bench) 用2,554个情节来测量代理记忆,将回忆分为空间,场景和事件记忆.
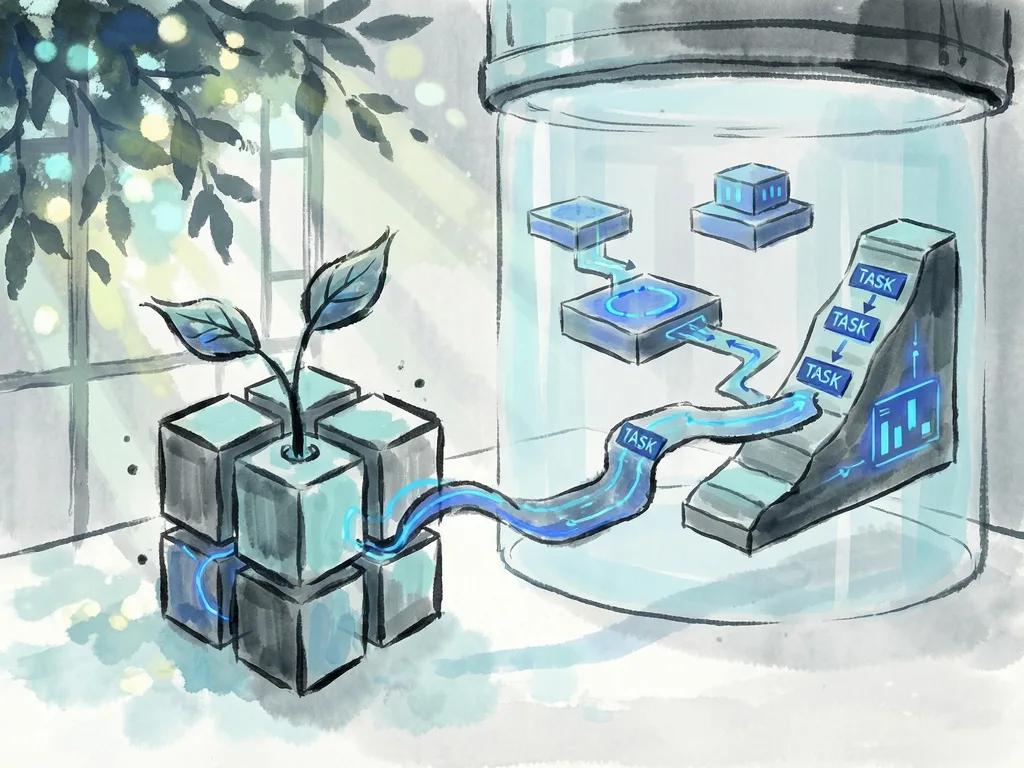
Skill2Env将技能转化为以能力为中心的可执行环境,难度模式和1.5K个经纪人后期培训轨迹.
合成乱的文档产生过推理痕迹来训练 LLMs ;一个35B学生在CL-bench上达到24.6%没有人类标签.
CompoWorld从448个服务和10,130工具中创建跨服务代理任务,在八个基准上将Qwen3.6-35B-A3B提升了9.17点.
TraceDance将真实部署痕迹转换为针对不良代理行为的目标基准,特别是在编码和一般工具使用中.它使用Anchor-and-Confirm检索加上Flash LLM确认以及 Anchor Synthesis Loop用于自定义行为的规格.基准评估决策点延续与标题对比.在252,…
最后OPD通过短暂调整最后一层,改善MATH-500分数来阻止Qwen3在政策上蒸.的潜在监督崩.
TimeEvo从失败中构建时间序列代理工具,通过配对录取添加仅证据的工具,并在三个骨干上测试十个任务.
D-JEPA将潜在的未来与决策价值保持一致, 改善控制,机器人技术,操纵和 autonomous driving 方面的行动选择.
Anthropic 报道说,950个 Claude 代理在21小时内发现了一种未被目录的DNA模式,并将其与CRISPR类似的意义进行比较.生物学家对这一说法提出质疑,称检测重复更容易于证明一个系统做了什么以及为什么它很重要.一些人还表示这种模式可能已经知道,这引发了关于AI信誉…
分散量子化将LLM个预填充和解码权重分割为速度和准确性;Qwen3.8提供NVFP4文物,代码和纸张.
一个简单的技巧可以通过减少最终层错误来改善输出头量化;方法,模型,基准,比特宽度和 hardware 是未知的.