
作为 Qwen , GLM 和 Kimi 的竞争对手,
梅塔推出了Muse Spark Open,一个具有816B参数的开放权重的 multimodal 模型,拥有42B个活跃参数,1M个上下文和在Hugging Face上的权重.它与 Qwen , GLM 和 Kimi 在代理和推理基准方面竞争,但是在编码和付费Muse Wonder Full模型方面落后.免费使用需要"用Muse Spark Open构建"标签;每年 89取超过$20M的API提供商需要单独的Meta协议.
主要内容
- 梅塔已经发布了 Muse Spark Open作为一个开放式 AI模型,总参数为8160亿个,活跃参数是420亿,多模式支持和100万个代币上下文窗口.
- 该模型被定位为一个强大的 US 开放式权重选项用于代理,推理和多模式任务,Meta声称它在选择的基准中表现优于Qwen,GLM和Kimi等几个公开竞争对手.
- Muse Spark Open 权重可在 Hugging Face, 可以在高端 hardware果硬件上本地运行,并且可以根据需要标签的许可证自由使用.
- 该版本并非完全取代Meta的付费 Muse Wonder 模型,因为它在编码基准上仍落后于一些竞争对手,并且仍然落后於更高层次的付款模式.
- 具有超过700万美元年收入的大型商业 API提供者需要与Meta签订单独的协议,从而在小规模使用和大规模商业转售之间进行划分.
超级描述:Meta的Muse Spark Open带来了816亿个参数,420亿活跃,多式联络支持和Hugging Face标记为开放权重许可证下的权重.
标签:Meta,Muse Spark开放式,打开重量 AI,拥抱面孔,多模式 AI
特色图像:抽象蓝灰神经网络节点和参数重量在黑暗的背景上,没有人,没有标志,没有文本
背景:在拉玛之后,梅塔重新开辟了重量之路.
Muse Spark Open 该公司将该模型描述为最有能力的 US 开放权重模型,定位它用于编码和代理任务.在一个开放式权重版本中,该模型的权重可供下载和本地执行而不是仅通过托管服务;在这里,Meta 将这些权重放在 Hugging Face 上.
该结构为开发者提供了一个中间路径.它比付费版更具控制性 API,但仍然承载着Meta的许可条款,基准要求和商业使用条件.
发展:一个816亿参数的多式模式
核心数字定义了Muse Spark Open .它有8160亿个参数,其中42十亿个是活跃的参数. 它支持文本,图像,视频和音频,并接受多达一百万个上下文令牌. 上下文是模型在工作时可以保持可用的输入和输出信息量;令牌是用来测量该信息的单位.
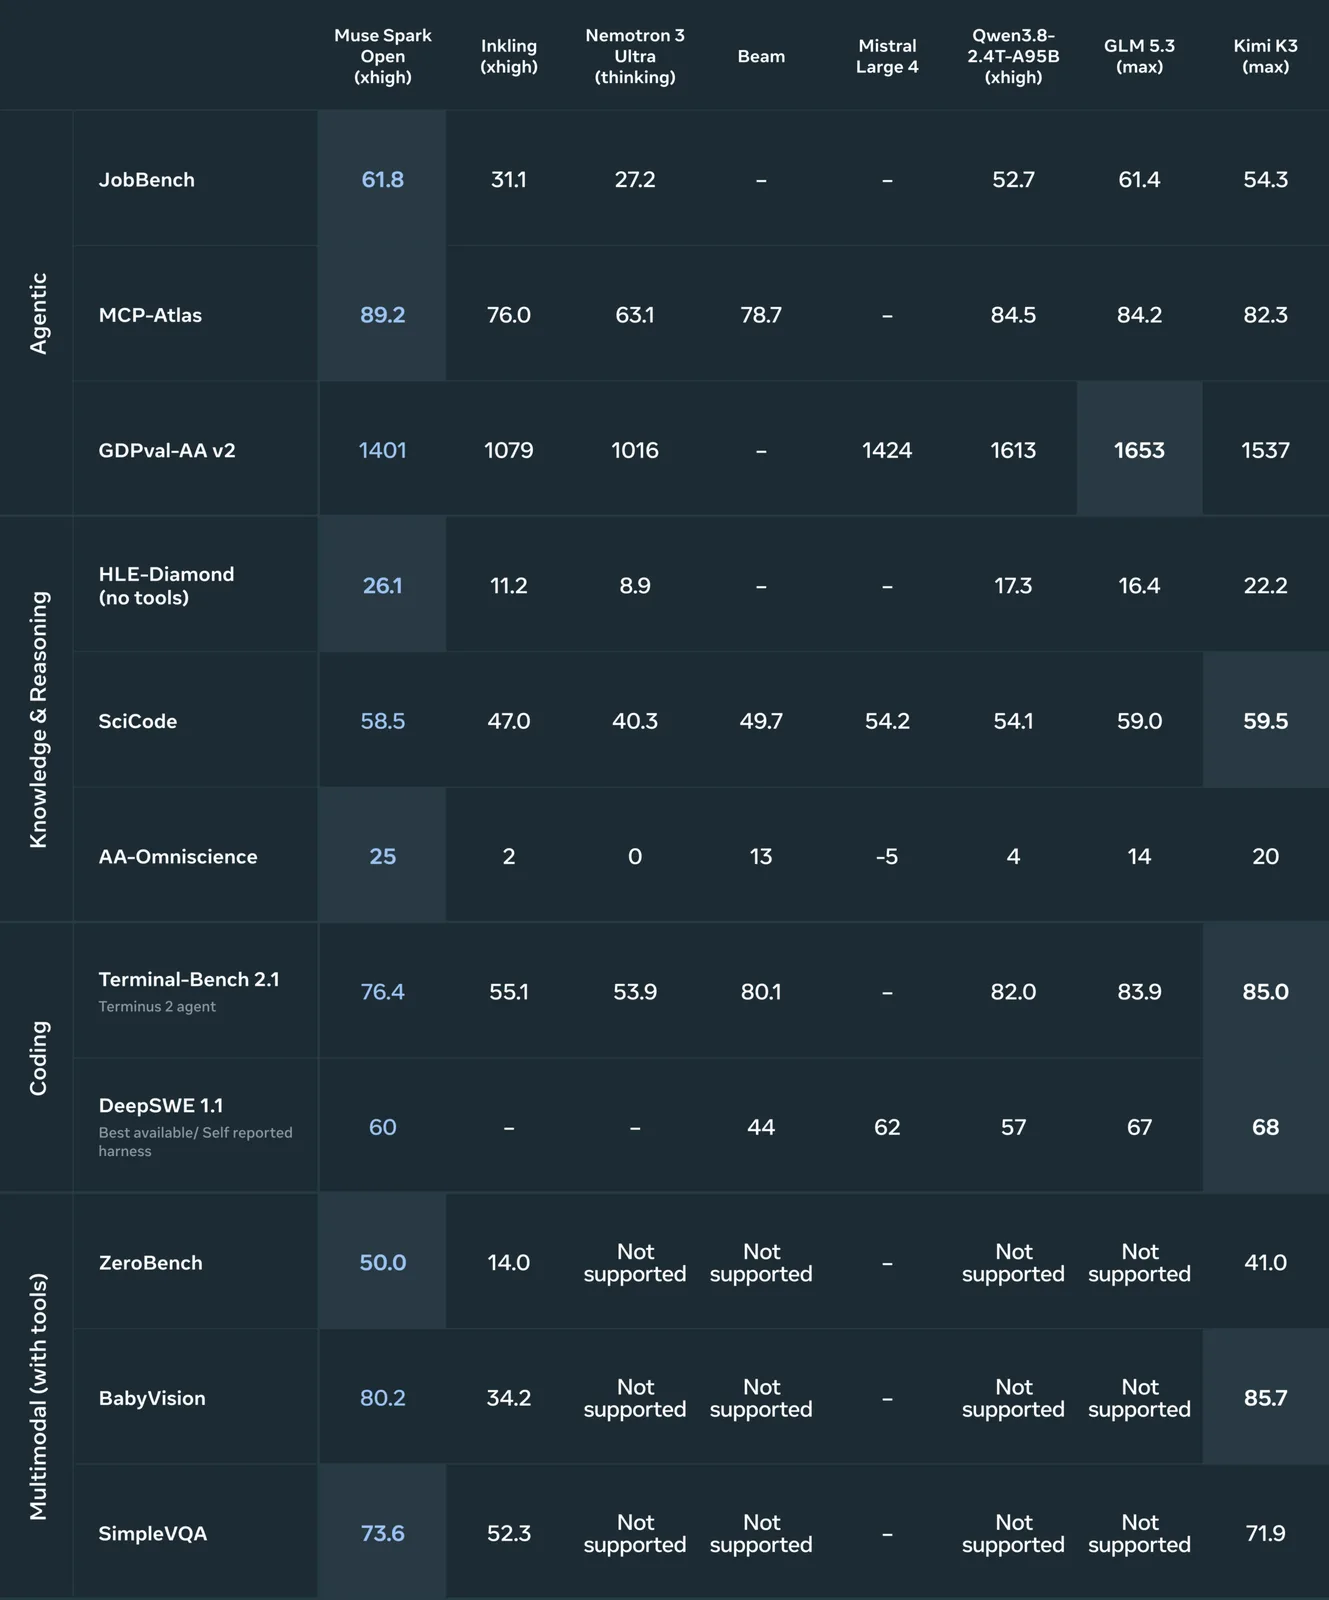
梅塔表示该模型与其他开放型号进行了比较,包括Inkling,Nemotron 3 Ultra,Qwen 3.8,GLM 5.3 和 Kimi K3.在Meta报告的结果中,该模型在JobBench,MCP-Atlas,HLE-Diamond和ZeroBench上表现良好,在几个类别中领先于Qwen 3.8 ,GLM 5.3 和 Kimi K3 . & 推理,和多模式类别. 这就是为什么我说了这句话.
与此同时,Meta承认它在编码基准方面落后于一些竞争对手,并且仍然落后於付费 Muse Wonder Full 模型.这种分裂很重要:该版本作为广泛的开放式重量多模式选项是最强大的,而不是替代 Meta 的更高层次的付费模型.100万个令牌上下文窗口和多模式支持扩展了该模型的用例超出仅为文字任务之外,而基准定位显示了开放型可访问性和最强 paid的付款模型之间的权衡.
最新阶段:本地运行,许可证标签和 API限制
对于更大的商业 API 分发,规则发生了变化:想要提供该模型作为服务的供应商每年需要与Meta签订单独协议.更多细节可以在Meta的研究博客中找到.
当前阶段是受控的开放权重启动.对于开发者来说,实际价值是局部多式推理,一个大的上下文窗口以及对开放模型的基准要求,特别是在代理和推理工作负载中.对于 API 卖家而言,免费使用是有条件的,每年700万美元的收入门创造了较小的实验与大规模商业转售之间的明确分离.
现在还需要观察的是,编码性能如何与实际使用中命名的开放竞争对手相比较,标签要求和 API协议如何影响商业采用,以及在后来的评估中 Muse Spark Open 与付费 Muse Wonder Full模型之间的差距有多大.
Comments
No comments yet. Be the first to comment.