
Intern Lumina U2是一个多代码库扩散LLM,用于全视觉理解和图像生成.
Intern Lumina U2是一个离散的传播LLM与1.4亿活跃参数,统一理解,生成和编辑在一个接口.
主要内容
- Intern Lumina U2是一个16.9B混合专家扩散LLM只有1.4B激活参数,统一图像,视频和3D理解与 text-to-image 生成和图像编辑.
- 它被描述为第一个在完全离散空间中模拟多代码库视觉 tokens 的扩散LLM,使用每个视觉位置8个AToken代码和并行解码.
- 其关键的架构优势是共享一个骨干,一个 token 接口和一个覆盖式传播目标在所有任务中,避免单独连续生成模块.
- 它报告了图像,视频,3D和 text-to-image 任务的强基准结果,包括与较大的统一和专业生成模型相比的竞争性性能.
- 它引入了Plateau-Halton采样与V-verify以实现4.45×端到端的图像生成加速,而扩展到更长的视频和更丰富的3D资产仍然是一个开放的问题.
Intern Lumina U2是一个单一的统一模型,可以处理图像,视频和3D理解以及 text-to-image 生成和图像编辑.它被描述为第一个在完全离散空间中模拟多代码库视觉 tokens 的DLLM.
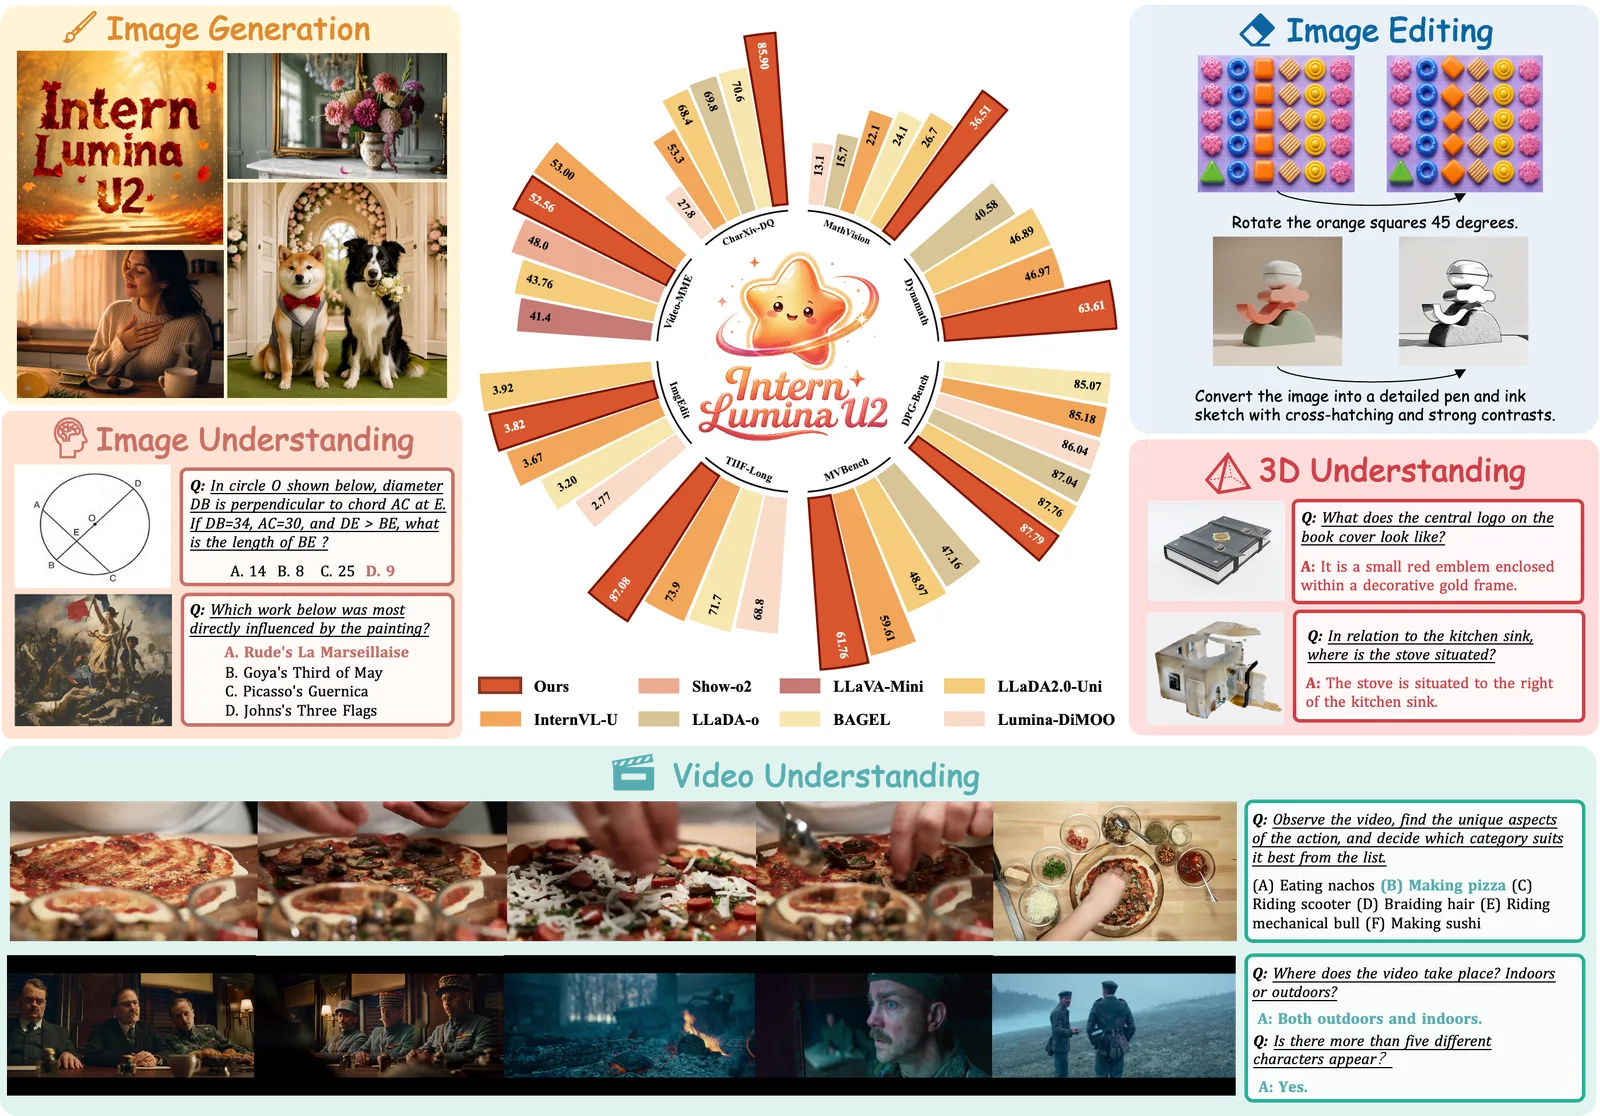
这个版本很重要,因为大多数统一系统仍然将单独的连续发生器螺栓在理解骨干上.Intern Lumina U2相反共享一个骨干,一个 token 接口和所有任务中的一个掩盖传播目标.
背景:为什么一个完全隐蔽的视觉界面
统一的 multimodal 模型通常面临着一个权衡.理解有利于语言骨干可以处理的离散的 large language model 3,而生成则经常依赖连续潜伏发生器.这种分裂增加了组件并使训练复杂化.
Intern Lumina U2通过保持整个视觉管道的离散来解决这个问题.每个视觉位置都带有8个AToken代码,这增加了细节而不会延长序列.位置由扩散骨干并行解码,而轻量级自动回归头预测每一个位置内的代码.
发展:培训和抽样选择
该模型在1,024 Ascend 910B NPU上进行训练,推断和评估,并额外运行 NVIDIA 用于跨平台验证.
对于生成速度,该团队采用了Plateau-Halton采样与V-verify (PHV),为图像生成提供4.45×端到端加快.
跨越理解和世代的效果
在图像理解方面,Intern Lumina U2在10个基准中的6项中排名最好或同等于最佳,并且超过了相同的脊柱LLaDA2.0-Uni在10分之8位.报告的得分包括CharXiv-DQ 85.9,HallusionBench 64.6,MathVision 36.5和DynaMath 63.6.
对于视频和3D,它领先于所有三个视频基准:Video-MME 56.7,MLVU 62.1 和 MVBench 61.8 . 它还记录了 3D MM-Vet 50.5 ,超过了3D专家ShapeLLM和PointLLM.
在 text-to-image 中,它是DPG-Bench (87.79),UniGenBench (86.11) 和TIIF- Bench (88.57短 / 87.08长) 的统一模型中的最佳,并与GenEval (89) 保持一致. 它在使用大约14×更少的激活参数时优于 FLUX.1 -dev和超越 Qwen -Image.
在科学图表上,它在VeriphyT2IBench (76.58,高于GPT-Image-1和 Gemini 2.5 Flash Image) 上获得了最佳本地分数,并在通用统一模型中获得最高的GenExam-Physics放松分数 (44.8).
接下来要看什么
标题要求是架构性的:一个离散的传播骨干,覆盖理解,生成和编辑没有单独的连续发生器,在1.4B激活参数.是否有效性超出基准套件,以及多代码库 token 方案如何扩展到更长的视频和更丰富的3D资产,这些都是值得跟踪的问题.
Comments
No comments yet. Be the first to comment.