
当输入被混.时, 视觉语言模型努力将属性与对象结合起来.
SABER 是一个对 multimodal 检索的受控基准,用于评估图像和文本配对之间的属性-对象绑定,包括复杂的场景.它表明CLIP式双编码器和 multimodal 嵌入器可以识别概念但错误地赋予对象属性.通过微调合成仅文本绑定的示例,该模型提高了跨模态和图像 - 图像检索,同时保持整体性能.
主要内容
- SABER是测试所有四种图像-文本配对类型和最多10个对象的复杂场景中的 multimodal 检索中属性 - 对象绑定的受控基准.
- 它表明CLIP式双编码器和 multimodal LLM嵌入器可以识别概念,但通常无法将属性绑定到正确的对象.
- 该基准重新构建了检索差距:挑战不仅在于概念的匹配,而且是在各种模式和拥挤场景中保持正确的关系意义.
- 作者训练了一个 multimodal LLM的嵌入器只在合成属性绑定文本上,没有图像监督,并且仍然改进了跨模式和图像-图像检索.
- 仅对文本具有约束力的监督也转移到相关的构成任务,包括否定处理和实例检索,这表明了更强大的实际路径 multimodal embeddings .
标签描述: 字体的类型是什么? (Meta description) SABER测试了四个图像-文本对的属性 - 对象绑定,暴露了CLIP和 multimodal 嵌入器故障,并显示仅文本检索收益.
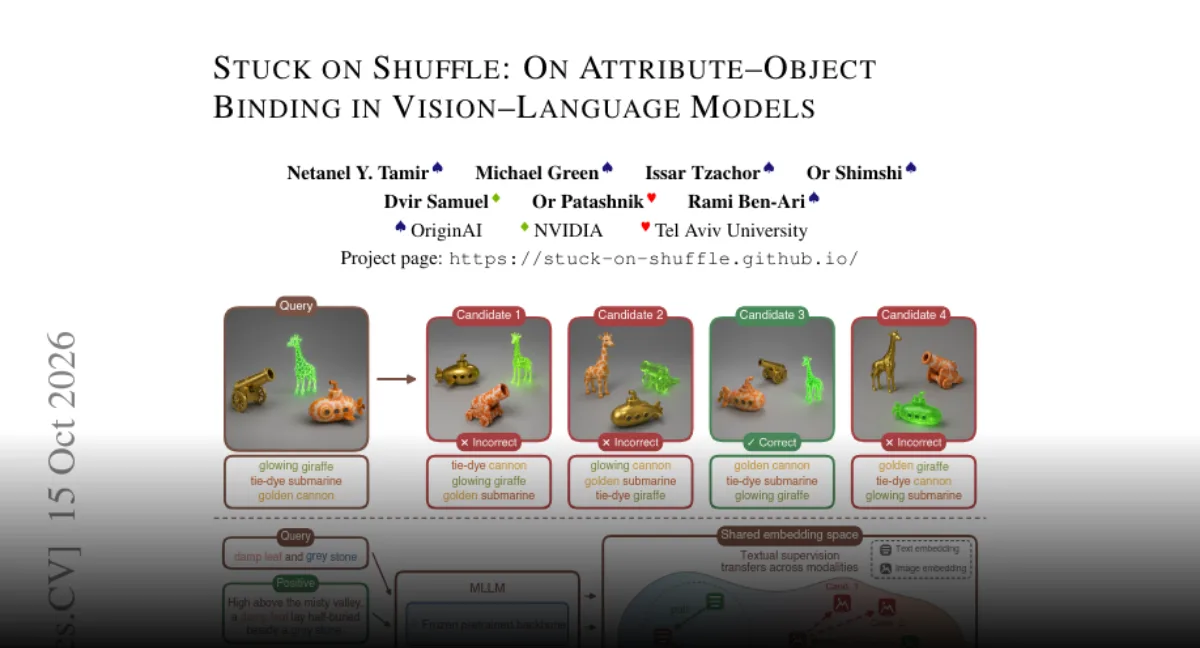
标签: 一个字母,一个字符号. (TG) " multimodal 检索,属性-对象绑定,SABER,CLIP,合成文本监督
首选图片: 在线视频, 下载地址: http://www. 抽象 embedding 空间连接图像和文本节点,没有人,没有标志,没有文字
SABER是 multimodal 检索的受控基准,它测试了所有四个图像和文本模式配对中的属性-对象绑定,包括最多十个对象的场景.这很重要,因为共享的 embeddings 可以识别概念而无需可靠地记录哪种属性属于哪些对象,这是之前仅部分覆盖过的故障模式.
embeddings 需要的不仅是概念
multimodal 的检索系统试图回答一个简单的问题:给定一个图像或文本查询,在一个大集合中最接近相关的项目是什么?许多系统依赖于共享的 embedding 空间,其中两个模式都投射到相同的矢量格式.这使匹配成为可能,但它不保证 embedding .
更困难的问题是属性-对象绑定. embedding 可能知道一个场景包含"红色"和"汽车",但仍然无法记录红色的属性属于那辆汽车而不是附近的另一个物体.早期的基准仅显示了这一问题的一部分:它们涵盖了有限的模式配对,经常使用简单的两种对象交换并依赖于小的属性的集合.因此,目前的模型是否可以在场景中更艰难地保持属性所有权稳定以及更多的查询目标组合尚不清楚.
SABER将作文变成一个考试
SABER在所有四个图像和文本模式配对中评估了属性-对象绑定,它涵盖多种属性类型和最多十个对象的场景.该设计将测试超越孤立交换并朝着检索系统面临的组合压力方向移动,当多个物体和属性同时存在时.
基准是诊断的.通过将绑定任务放置在检索中,它询问 embeddings 是否可以保留关系意义而不是 JUST 匹配单个概念.如果一个模型混了哪个对象携带属性,即使这些概念本身被表示也可能受到检索得分的影响.
现有的模型显示易碎的联系
在SABER上的测试揭示了两个广泛的模型家族中的实质性的绑定失败:CLIP式双编码器和最近的 multimodal large language model 嵌入器. 发现表明共享表示并不意味着自动共享理解. 一个系统在识别概念时可能很强,但当被要求将属性连接到正确对象时仍然脆弱.
结果还重构了检索差距.问题不仅在于模型是否可以将文本映射到图像或图像与图像之间,而且它是否能够保持正确的对象属性关系随着场景变得更加拥挤和查询方式之间的转移.
合成文本成为监督层
如果绑定是弱点,直接训练它是一个自然的反应. multimodal 监督可以帮助,但收集适合控制绑定示例的图像是困难和昂贵的. 文本提供了更便宜的途径. 它可以产生更广泛的属性,并且能够精确地控制硬负面.
因此,这项工作完全基于合成属性绑定文本的 multimodal large language model 嵌入器进行了微调.在该培训步骤中没有图像监督.尽管存在这种限制,但收益转移到跨模式检索和图像-图像检索上,同时保持一般的 large language model 280003性能.
当前阶段和更广泛的检索收益
由此产生的模型在SABER上取得了最先进的结果,并且还改善了否定和实例检索基准.这表明好处不仅限于一个人工测试.专注于绑定的监督可以加强相关组合技能,包括处理被否定的描述和获取特定实例.
在这个阶段,SABER标记了一个更清晰的故障模式和一个实际的缓解路径.基准定义了 multimodal embeddings 断裂的地方,而仅文本训练结果表明可以在不先收集昂贵的图像集体的情况下改进绑定.
Comments
No comments yet. Be the first to comment.