
解量化:调整LLM个预填充和解码阶段
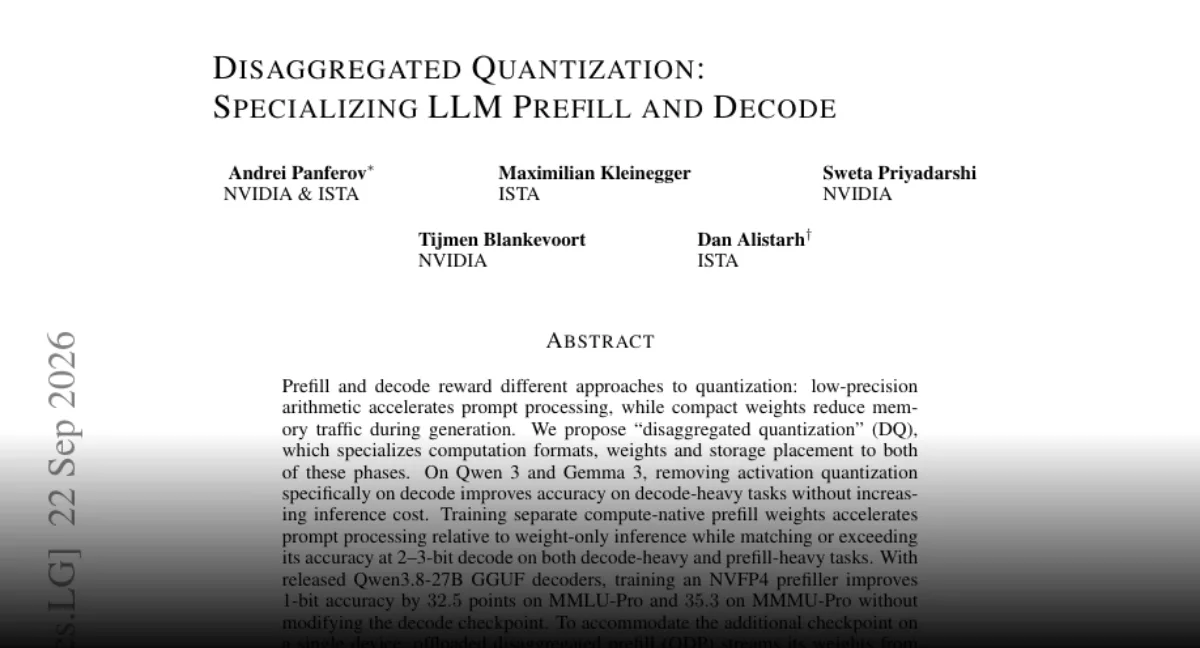
分散量子化将LLM个预填充和解码权重分割为速度和准确性;Qwen3.8提供NVFP4文物,代码和纸张.
关键点
- 分散量子化将LLM的预填充和解码分为不同的重量路径,允许每个阶段使用自己的数值精度.
- 这避免了强迫单个量子化检查点优化提示处理速度和 token 生成精度的权衡.
- 该方法使用内存卸载来支持分割,在设置后没有报告长序密集服务的额外开销.
- 它可以应用于现有的量子化检查点,而不是需要一个全新的量子化基线.
- 公共文物包括arXiv:2609.26333,IST-DASLab存储库和Qwen3.8 27B NVFP4预填充模型.
分散量化是 large language models 或 LLMs 的一种技术,它将快速处理和 token 生成视为可以使用不同的数值精度的两个权重路径.Qwen3.8给了这个想法一个具体的公共文物:27B NVFP4预填充器,纸质标识符2609.26333以及IST-DASLab下的代码.对于 LLM服务后的读者来说,变化在于单个量化的权重副本不再需要同时满足速度和准确性的需求.
背景:一个量化模型,两个不平等的工作
LLM推理通常有两个阶段.预填是第一个通过提示符,模型将许多输入 tokens 转换为缓存状态.它可以计算繁重并且经常从并行性中受益.解码是生成循环,其中一个 token 接着另一个产生;它往往更多地依赖于移动权重和缓存状况而不是一次执行多个独立的计算.
量化降低了权重的数值精度,在某些系统中,激活.这可以减少内存使用和提高吞吐量.难点是两个阶段共享一个精度设置.加快预填充的设置也可能影响解码的准确性.保护准确性的设置可能会使长序列服务成本过多地存在于表上,特别是在密集模型中,所有参数都参与每个步骤.
发展:按阶段划分权重
分散方法将用于预填充的重量与用于解码的重量的分离,允许每个阶段以不同的精度运行.所述的好处不是 JUST 一个指标:它可以提高速度和准确性.这意味着系统可以选择一种精度路径进行快速处理,另一种为 token 生成而不是强迫两者通过相同量子化检查点.
该设计还使用卸载. 卸载将重量移动到内存层之间,以便在需要时可以使用正确的精度路径.对于长序列和密集模型,该源描述这是产生零额外开销,这意味着阶段分割在系统配置后不应增加额外的运行时间成本.
一个实用的点是兼容性.该方法被描述为适用于现有的量子化检查点,这意味着它可以叠加到已经压缩的模型文件上,而不是从头开始要求新的量子化基线.
最新的文物:纸张,代码和Qwen3.8 NVFP4
研究记录列为 arXiv:2609.26333 在 https://arxiv.org/abs/2609.26333. 实现是公共的在 https://github.com/IST-DASLab/disaggregated-quantization. 该模型侧文物是一个Qwen3.8 NVFP4预填充器,可用于https://huggingface.co/ISTA-DASLab/Qwen3.8-27B-NVFP4-prefiller. 名字27B表示该预填补器的参数尺度,而NVFP4指的是用于该组件的4位浮点格式.
该源没有提供发布日期,因此最明确的标记是纸张号码,存储库和名为Qwen3.8 27B NVFP4预填充器.它们一起显示了从纸张和代码路径向可下载模型文物移动的想法.
当前阶段是公开的研究代码和命名预填充器,而不是一个声明的生产产品.接下来要关注的是推断堆是否会作为例行选项暴露单独的预填补和解密权重,现有的定量化检查点是否可以在没有精度惊喜的情况下采用分割,以及卸载是否保持长序列密集服务免于纸张设置之外的额外开销.
标签描述: 字体的类型是什么? (Meta description) Qwen3.8 27B NVFP4预填充器展示了分解量子化如何分离LLM个预填补和解码重量,以提高长序列的速度和准确性.
标签: 一个字母,一个字符号. (TG) " LLM 推断,量化 Qwen3.8,NVFP4,分类的量化
首选图片: 在线视频, 下载地址: http://www. 没有企业标志,也没有文字, 有两个并行推断路径.
Comments
No comments yet. Be the first to comment.