
TimeEvo:通过失败驱动的学习自我进化的时间序列代理
TimeEvo从失败中构建时间序列代理工具,通过配对录取添加仅证据的工具,并在三个骨干上测试十个任务.
主要内容
- 时间序列代理的固定的专家策划工具库被 TimeEvo 用一个基于故障驱动的过程取代,该流程从诊断的能力缺口构建工具.
- 它聚合了代理失败,计划错过的测量和合成仅提供证据支持的工具而不需要直接猜测答案.
- 候选工具库必须通过配对的运行时间入口,因此在执行过程中测试工具的有用性而不是仅根据预运行的平均值进行判断.
- 十个时间序列质量保证任务和三个骨干的实验表明,从一个空库开始可以提高准确性并保持从较弱到更强模型的可移植性.
- 这种方法针对两个失败模式:人-代理工具错位和"无声损害"来自通用的自我修订,可以通过很少可见的得分变化来破解答案.
标题:TimeEvo用运行时间接入替换了21个静态工具
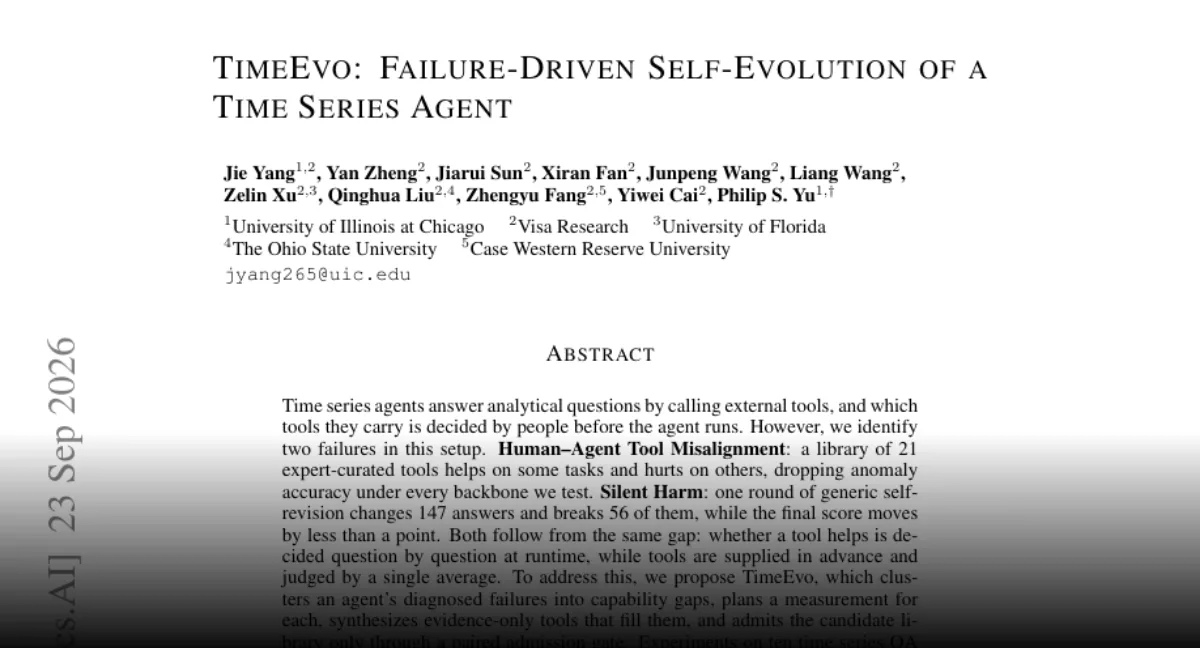
超级描述:TimeEvo通过诊断缺口来取代静态工具库,并通过对联网关在十个任务和三个骨干中添加仅供证据的工具.
标签:TimeEvo,时间序列质量保证,AI代理程序,工具库,运行时评价
主要图像:抽象时间序列仪表板与链接的工具节点,没有人,标志或文本.
TimeEvo改变了时间序列代理如何从诊断失败中构建工具库,而不是依赖固定的人类策划集来获取外部工具.这很重要,因为工具的有用性在执行过程中逐个问题出现,而工具集是事先创建并以一个总和平均得分.
背景:在处决前选择的工具
时间序列数据的代理通过调用外部函数来解决分析问题,例如总结,预测,检测变化或从一系列观察中计算统计数据.在描述的设置中,工具清单是在代理运行之前被固定的.人类专家提供该名单,代理使用它发现的任何工具.这种设计使得工具选择可预见,但它也隐藏了一个实际的问题:一个工具的价值取决于被问到的问题,而不仅仅是工具的名声.
一个固定的库在某些任务中可能是有用的,而在其他方面则有害的,因为它鼓励代理人寻找熟悉的操作,即使更简单或不同的测量会更好.作者称这种失败为Human-.Agent Tool Misalignment他们用一个由专家策划的21种工具库来说明这一点.该库可以帮助一些任务同时伤害其他人;它还降低了异常准确度 (检测不规范模式的得分) 在每个经过测试的骨干下面.这里的骨干意味着主机和调用的基础语言模型.
发展:21个工具和一个无声的修订轮
第二个失败模式在代理产生答案后出现.作者描述了一轮通用自我修订,其中要求代理审查和调整自己的响应而没有特定任务的理由来更改它们. 在这样的一个回合中,有147个回答改变了,56个这些变化打破了答案,而最终得分移动不到一点.他们称之为Silent Harm因为可见的得分几乎没有发生变化,尽管许多答案被改变了,而且很多变化都是错误的.
这两种失败都有一个共同的根本原因.在执行过程中,每个问题都决定了有用性,但可用的工具是事先组装并通过总体平均值进行评估的.这种差距给出了一个误导性的图像:当某个代理人在特定异常检测任务上犯下可以避免的错误时或在自我修改期间aging然破坏正确答案时,可能会被认为是合适的.
最新进展:从诊断的缺口建立图书馆
时间Evo通过改变图书馆的构建方式来解决差距.它不是从一套固定的专家工具开始,而是从诊断代理失败的地方开始.被诊断的故障将聚集到能力缺口中,这意味着缺乏测量或推理能力的类别.对于每个缺陷,TimeEvo计划一个测量,然后合成可以填补这个空白的仅依据证据的工具.只限于为问题提供可观测的支持而非直接猜出答案.
候选库不仅因为看起来有用而被接受.它必须通过对接入口,这是一个选择步骤,只有在对比后才允许候选图书馆.这使得图书库的增长与运行时需要联系在一起,而不是单一的预运行的平均值.
当前阶段:空图书馆,十个任务,三个脊椎
实验涵盖了十个时间序列质量保证任务,在观测顺序上回答问题和三个骨架.TimeEvo从一个空库开始,这意味着它不依赖于之前的21个专家策划的工具作为起点. 在这些条件下,它提高了所有10个任务和全部三种骨架的准确性.作者还报告了可移植性:基于廉价模型增长的图书馆在安装到更强大的时仍然获得优势.
该代码可在 https://github.com/Muyiiiii/TimeEvo.
对于代理构建者来说,这项工作现在指向了一个更狭窄但实际的问题:哪些工具应该在经过配对运行时测试后才能进入库,以及当代理自我修改答案时,该测试是否可以保持异常准确度.
Comments
No comments yet. Be the first to comment.