
CompoWorld:为通用代理商扩展组合环境
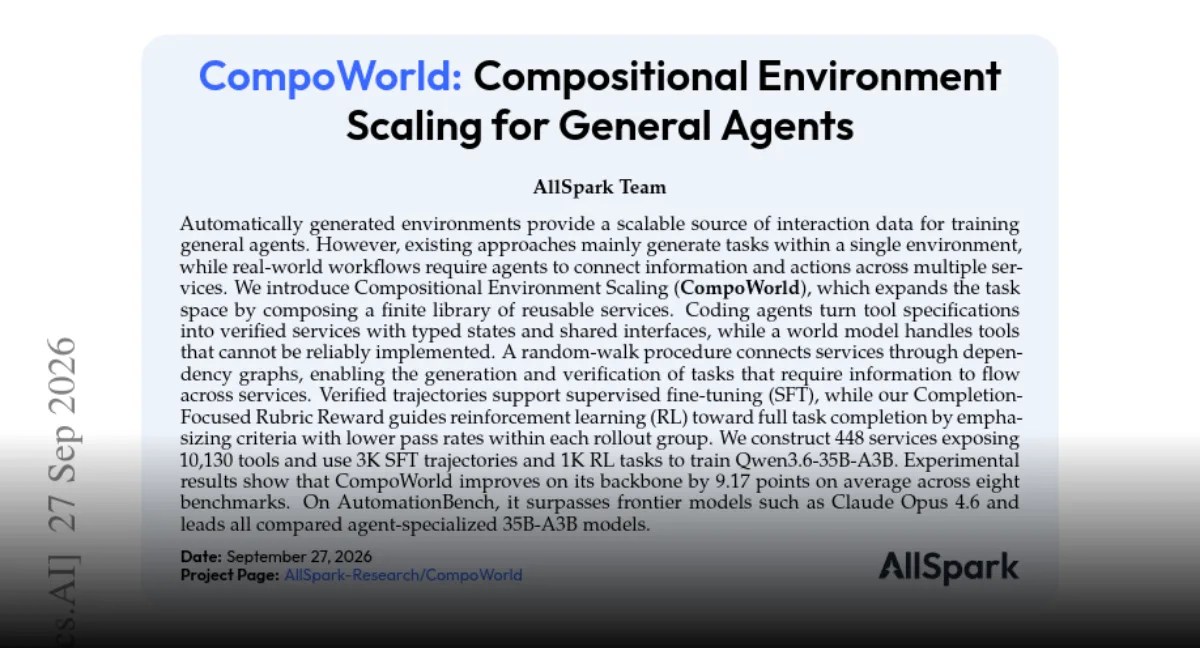
CompoWorld从448个服务和10,130工具中创建跨服务代理任务,在八个基准上将Qwen3.6-35B-A3B提升了9.17点.
主要内容
- CompoWorld是一种训练数据方法,通过将可重复使用的服务结合到跨部门任务中来扩展一般AI代理.
- 管道将工具描述转换为具有类型状态和共享接口的验证服务,然后使用依赖图来生成需要跨多个服务信息流动的任务.
- Qwen3.6-35B-A3B接受了 3K监督的 fine-tuning 轨迹和 1K强化学习任务的训练,使用完成Focused Rubric Reward来鼓励完全完成任务.
- 该方法构建了448个暴露 10,130 工具的服务,与骨干模型相比,在八个基准指标中平均获得了 9.17 分.
- 在AutomationBench上,受过训练的模型超越了前沿系统 (如Claude Opus 4.6),并领先于与代理专业 35B - A3B 模型相比较,这表明在面向自动化的多服务设置中取得了强大的结果.
标签描述: (中文) 字体: ... " . " " " CompoWorld使用448个服务和6种工具进行代理培训,在多服务任务中的八项基准中将Qwen3.6-35B-A3B提高了7分.
标签: 一个字母,一个字符号. . . . ,. 计算机世界, AI代理商, Qwen3.6-35B-A3B, 自动化基板, reinforcement learning
首选图片: 在线视频, 下载地址: http://www. ![抽象技术风格特色图像显示连接的服务和代理工作流程,没有真实的人,没有公司标志,没有文本]
CompoWorld (简称 Compositional Environment Scaling) 是一种用于一般代理人的训练数据方法,通过结合可重复使用的有限库来扩展任务生成.该管道产生 448 个服务,后面有 10,130 可用的工具,创建跨服务任务,并利用 3K监督 fine-tuning 的轨迹和 1K增强学习任务培养 Qwen3.6-35B-A3B .测量的收益是 9.17 在八个基准中平均积分超过骨干,这一结果很重要,因为代理人越来越需要在多个服务之间连接信息和行动,而不是在一个孤立的环境内运行.
背景:单一环境任务与实际工作流程不匹配
生成环境通常用于为一般代理产生大量的交互数据.缺点是大多数管道将任务生成保持在一个环境中.实际的工作流程不同:一项任务可能需要代理读取一个系统,转换结果,更新另一个系统并验证最终状态是否完整. 在这些情况下,最困难的是跨服务信息流,而不仅仅是正确调用一种工具.
CompoWorld通过将服务构成作为扩展单位来解决这一差距.可重复使用的有限库成为任务生成的基础.当服务链接时,由此产生的问题可能需要数据从一个工具转移到另一个工具.
发展:工具规范成为验证服务和跨部门任务
管道从编码代理开始.它们将工具描述转换为具有类型状态和共享接口的检查服务.类型状况定义了每个服务预期或返回的数据,而共享界面给构成层提供了一种可预测的方式来连接服务.如果无法可靠地实现一个工具,世界模型就会处理它,因此工作流仍然可以在没有脆弱的工具代码的情况下进行表示.
一旦服务可用,随机步骤将它们连接到依赖图中.这些图编码了需要哪个服务输出作为另一个服务输入.结果不是随机的呼叫列表,而是生成的任务,该任务要求信息在服务之间流动,并且可以对该流进行验证.
在 fine-tuning ,或RL中,CompoWorld使用了Completion-.Focused Rubric Reward该标题将任务成功划分为标准,并强调每个部署组内的较低通过率的标准.这推动代理人完成全部任务而不是通过多服务工作流程的简单早期步骤奖励部分进展.
最新进展: 448 项服务, 10,130 工具和 9.17 分的增长
构建环境库包含448个服务暴露 10,130 工具.训练使用 3K SFT轨迹和 1K RL任务来调整Qwen3.6-35B-A3B.根据八项基准测量,该方法在骨干中平均增加了 9.17 分. 在AutomationBench上,受过训练的模型超越了边界系统如 Claude Opus 4.6 和所有与代理专业 35B - A3B 模型相比较.
AutomationBench的结果值得注意,因为报告中的比较将Qwen3.6-35B-A3B置于 Claude Opus 4.6 和其他特种代理 35B - A3B模型之上. 跨八个基准标准的 9.17 分平均也表明好处不仅限于单一任务格式,而该模型在面向自动化的评估环境中进行测试.
目前阶段:为代理人培训提供服务组合管道
CompoWorld正在展示一个完整的数据生成到训练循环:工具规范成为服务,服务变成依赖图表,与图形连接的任务成为验证轨迹,并以标题指导 reinforcement learning 使用这些轨迹来更新Qwen3.6-35B-A3B.关键数字是448个服务,10,130 工具,9.17 SFT轨迹,Claude Opus RL任务以及八项基准中的9.17点平均增益.
接下来要关注的是,这个有限的服务库是否继续在更大规模上产生经过验证的跨服务任务,以及AutomationBench领先于 Claude Opus 4.6 和其他代理专用 35B - A3B模型,因为评估设置和服务组合变得更加复杂.
Comments
No comments yet. Be the first to comment.