
培训如何利用从公开文件中生成的合成数据来学习
合成乱的文档产生过推理痕迹来训练 LLMs ;一个35B学生在CL-bench上达到24.6%没有人类标签.
主要内容
- 由于公共网络数据在很大程度上已经耗尽,并且可以鼓励记忆而不是真正的环境学习.
- 这项研究通过扰乱高质量的公共文件, 构建了一个合成的培训管道, 并在没有人为注释的情况下产生依赖上下文的推理痕迹和答案.
- 该管道有四个阶段:重写文档以减少记忆,生成需要文件推理的问题和标题,使用文档作为上下文来回答,并过样本,只保留那些真正依赖于所提供的背景的人.
- 在约1000个合成样本上训练Qwen3.6-35B-A3B学生,将CL-板性能从SFT后的13.7%提高到22.8%,并在标题奖励 reinforcement learning 之后为24.6%,使其接近2.4T参数边界模型.
- 这些收益主要转移到长文本理解,指令遵循和推理方面,而代码生成和一般知识在很大程度上保持不变,留下关于较少公众和更专业领域的开放问题.
large language models 通常在任务依赖于推断时间提供的复杂上下文而不是在其权重中烤的知识时会遇到困难.为此类特定任务环境收集人类注释是昂贵且难以扩展的,公共网络很大程度上已经耗尽:其中大部分内容已在预训练期间见过,因此对公开文件的天真培训奖励记忆而不是真正的背景学习.
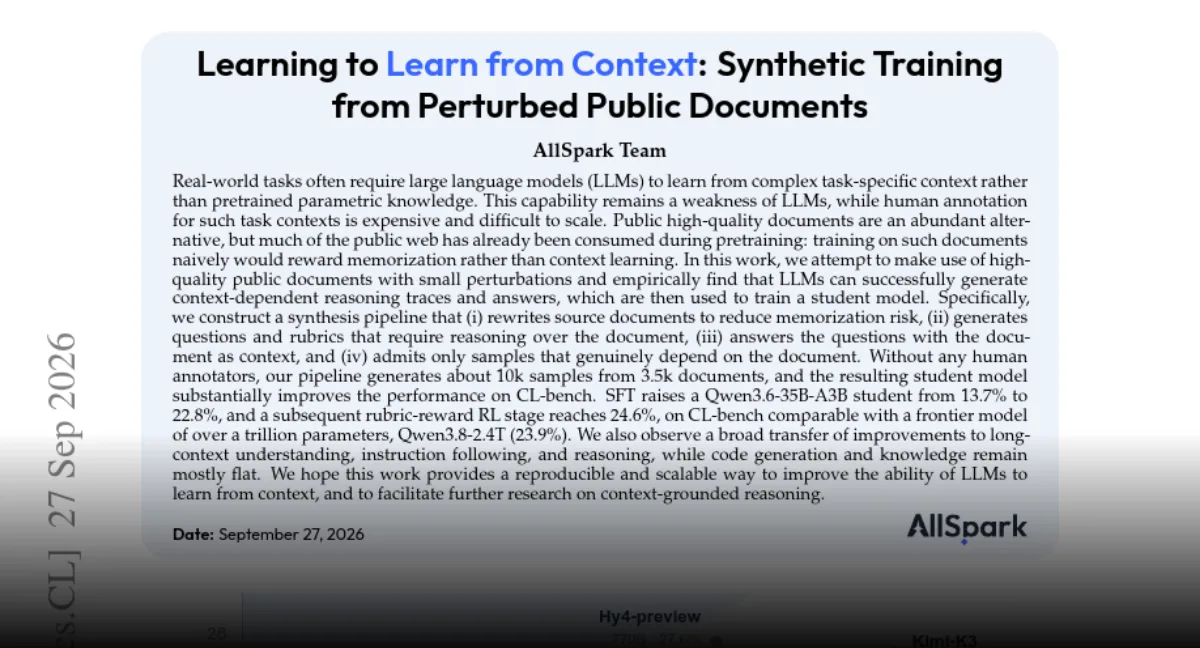
一项新的研究努力通过扰乱高质量的公共文档并使用模型来生成取决于上下文的推理痕迹和答案来解决这个问题,然后训练一个较小的学生模型.
合成管道是如何工作的
管道有四个阶段.首先,它重写源文件以降低模型简单地回忆它们的风险.第二,它生成需要对文档进行推理的问题和标题.第三,它用文档作为上下文来回答这些问题.第四,它只承认真正依赖于文档的样本,过.出仅基于参数知识才能解决的案例.
结果:大约 10千个样本 来自 3.5万份文件这是什么?
在CL-bench上的数字
培训一个 文3.6-35B-A3B 在此数据上,学生将CL-bench性能从 13.7%至22.8%之间 在监督后 fine-tuning . 随后的标题奖励阶段达到 reinforcement learning 24.6% 其他类型的产品: () 制品. .这是什么?
这使得89万名学生与 黄金3.8-2.4T一个具有超过一万亿参数的前沿模型, 能够得分为 23.9% 其他类型的产品: . . . ,. . , . 在同一基准上.
利在哪里转移,以及它们不在哪里
在长文本理解,遵循指令和推理方面有广泛的改进.代码生成和知识大多保持平稳,这表明管道针对的是具体而不是一般能力的基于背景的推理.
作者将这项工作定位为一个可重复的,可扩展的途径,以更好地学习上下文,并作为进一步研究基于背景推理的基础.当文件不那么公开时,领域更加专业化或过.步骤允许太少样本来维持培训时,这个方法是否有效?
Comments
No comments yet. Be the first to comment.