
深度基准:量化剩余连接如何促进更大的计算深度
在固定的尺寸和训练下进行DeepthBench测试10 Transformers 时,只有当剩余设计和规范化设计保持计算时才能显示深度.
主要内容
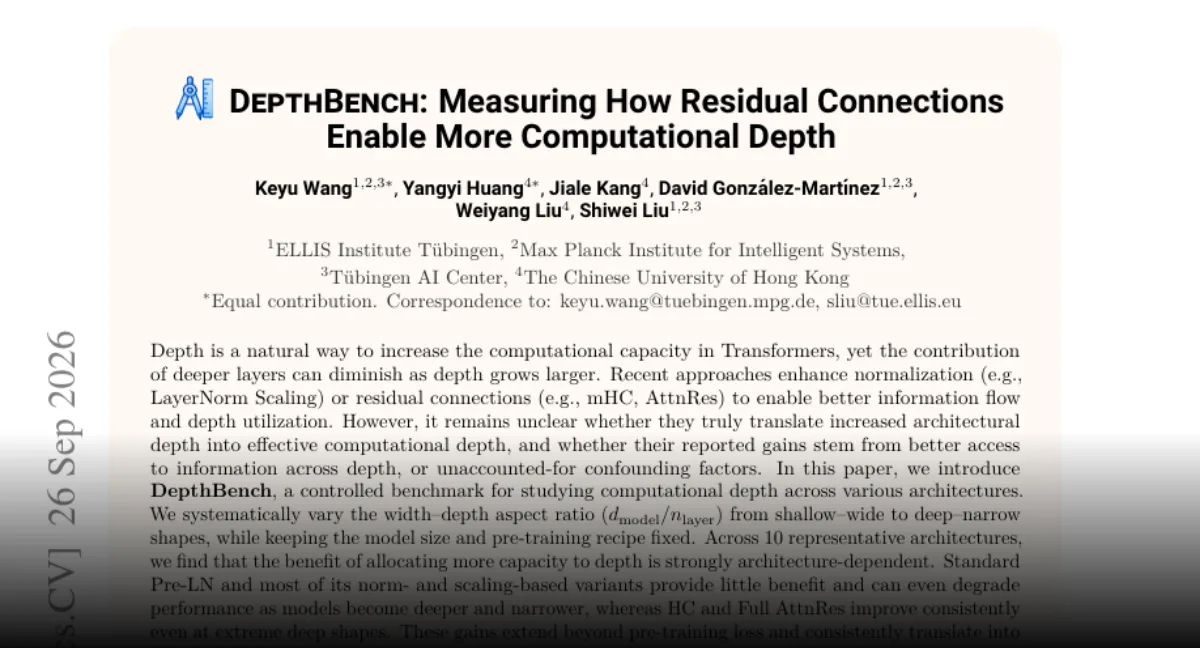
- DepthBench是一个受控的基准测试10 Transformer 架构,同时保持模型大小和预训练配方固定.
- 它通过比较从浅宽到深窄设计的不同宽度-深度比例来研究增加深度是否真的能提高有效计算.
- 主要发现是深度增长取决于架构:标准的Pre-LN和许多基于规范化的变体通常很少受益或在非常深时会降解.
- 像HC和Full AttnRes这样以残余为重点的方法在深窄模型中持续提高性能,这表明更好的信息路由是有效使用深度的关键.
超级描述:DepthBench测试了10个 Transformer 架构,并显示深度增长取决于剩余和规范化设计,而不是单独的模型大小或预训练配方.
标签:DepthBench, Transformer 深度,计算深度
主要图像:抽象的技术风格,分层 Transformer 架构与剩余路径,没有人,标志或文本.
背景:更深层不会自动添加计算
DepthBench是研究 Transformer 架构中的计算深度的受控基准.它询问是否使模型更深确实增加了有效的计算,或者明显的收益来自混.因素.通过比较固定模型大小和预训练配方的10个代表性架构,该基准将建筑形状与培训条件分开.这很重要,因为如果以后层改变计算,那么更深的堆叠才有用;否则,添加深度可以消耗容量而不会产生更好的模型.
Transformers 通过堆叠层来增加容量.每个层可以转换表示,因此深度是添加计算的自然方法.但随着堆增长,一个层的价值可能会下降:信息可能变得多余,信号可能衰退或正常化可能扭曲从输入到输出的路径.为了应对这一点,最近的方法已经改变了规范化,例如LayerNorm Scaling,或者残留连接,如mHC和AttnRes.这些方法旨在改善信息流动和深度利用. 开放的问题是它们是否将架构深度转换为计算深度,还是仅仅受益于早期报告中未分离的因素.
开发:DepthBench隔离了宽度和深度的权衡
DepthBench通过控制式设计来回答这个问题.它从浅宽到深窄的形状变化了 dmodel/nlayer 的宽度-深度比率.在每个形状中,模型大小和预训练配方保持不变.这消除了通常的混因素:总参数预算和预培训配方不会改变,因此差异可以归因于宽度和深度之间的容量分配方式.dmodel / nlayer 的广度- 深度比值捕捉到了这种权衡:低比例表明一个狭窄而深厚的模型,高比例则表明一个宽而浅的模型.此后该基准检查了 10 种代表性架构,包括标准 Pre-LN 和基于规范或缩放的变体以及剩余聚焦方法,如 HC Full AttnRes.
最新进展:10个建筑显示不均 Dep的深度回报
核心结果是深度取决于架构.对于标准的Pre-LN和大多数基于规范或缩放的变体,在减少宽度时添加更多层通常带来很少的好处. 在某些深窄配置中,性能可能会降低. 相比之下,HC和Full AttnRes即使是在极端深厚的形状下也会持续改善. 其结果不是深度无用,而是它的价值取决於允许信息和梯度跨层移动的内部路由规则. 该论文还指出,收益不仅限于训练前损失.它们携带到特定领域的性能和有效计算,这表明改进的信息流模型有助于使用其深度而非仅适应预训练目标.
当前阶段:有效深度成为扩展问题
控制的层级分析进一步支持了这一读数:HC和Full AttnRes的好处似乎与信息如何通过层移动有关,而不是 JUST 对层次的数量.在这个阶段,DepthBench为研究人员提供了一种方法来测试一个架构是否将深度转换成固定尺寸和训练条件下的计算.下一个值得关注的信号是未来扩展研究是否报告只有当有效的计算深度提高时才会有深度增长,以及在这里检查的10个架构之外是否存在相同模式.
Comments
No comments yet. Be the first to comment.