
意想不到的成功,持续的失败:以 89率驱动的探索信用分配在LLM推理中
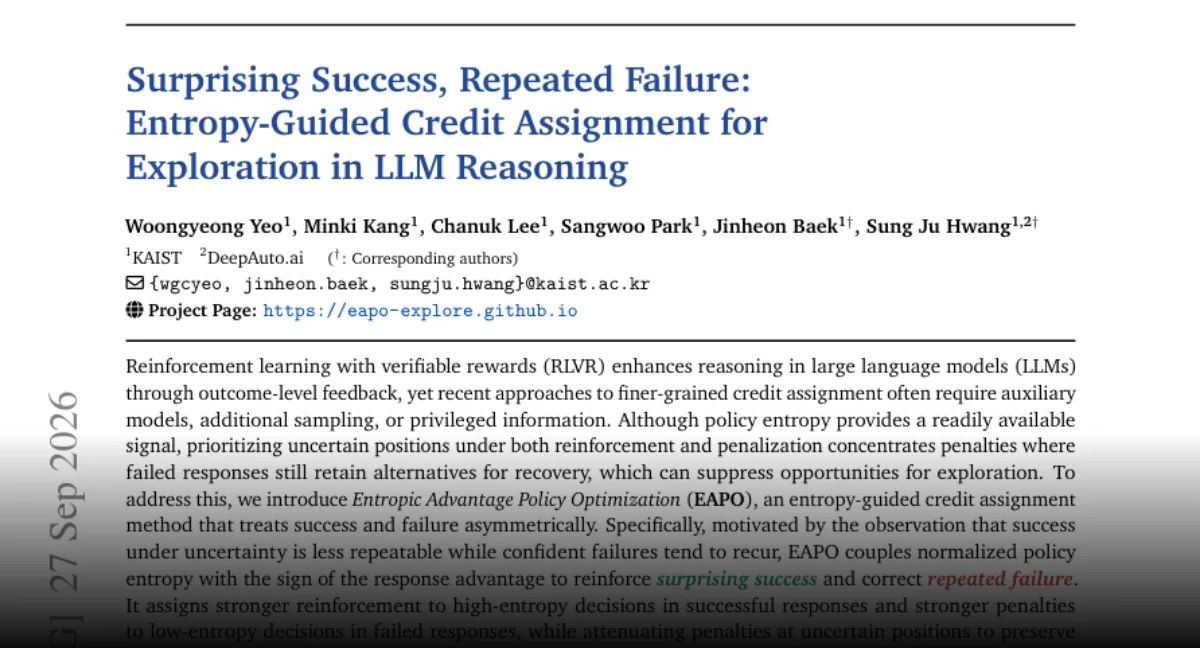
在LLM的推理中,EAPO使用来分配代币信用,惩罚自信失败,奖励不确定的成功,并保持复苏.
主要内容
- 对于LLM的推理,EAPO引入了以.为导向的代币级信用分配,将响应级优势重新分配到单个代币中.
- 对于失败的响应,它会更强烈地惩罚低.和自信的代币以针对重复错误.
- 对于成功的响应, 它奖励高.率, 不确定的代币来加强探索.
- 它减轻了不确定的处罚, 以保持推理链中的恢复路径.
- 这种方法是一个新提出的培训机制,其实际影响还需要在更长和更复杂的推理任务上进行测试.
标签描述: 字体的类型是什么? (Meta description) 通过惩罚自信的失败,奖励不确定的成功和保护探索恢复路径来引导EAPO在LLM推理中的代币信贷.
标签: 一个字母,一个字符号. (TG) " 欧盟经济合作伙伴组织,欧洲经济联盟
首选图片: 在线视频, 下载地址: http://www. 没有人,公司标志或文字的抽象技术风格网络.
Entropic Advantage Policy Optimization,简称EAPO,是一种以 89为导向的信用分配方法,在LLM推理中引入用于探索.它的意义来自于推理训练中的持续差距:一个模型通常会收到整个答案的一个优势值,但答案是由许多代币选择组成的.如果响应失败了,单一值不会显示哪些自信步骤导致故障.如果反应成功,单个值不会表明哪些不确定步骤是值得尝试的. EAPO通过重新配置每个响应的优点来解决这个缺口.
背景:响应级奖励让代币级的指责不清楚
LLM推理的强化学习通常在完整响应水平上提供反.一个模型生成了一系列代币,该序列被判定比基线更好或更差,并且这种判断成为更新策略所用的优势.信用分配是决定顺序中哪些部分值得奖励或处罚的问题.
这一问题在推理任务中尤为明显.一个链条可以从正确的前提开始,迈出错误的一步,后来恢复,并且仍然以被认为是好的或坏的答案结束.因此,响应级别优势可能过于直截了当.它可能会将责任分配到有帮助的代币上或者把信誉分散到没有帮助的人身上.
在这里,.变得有用.在这个设置中,描述了模型对下一个令牌的不确定性.低意味着一种延续看起来占主导地位.高表示几个延续仍然可信.EAPO使用这种不确定性的信号来指导学习压力应该降低的地方.
发展:变为路由信号
EAPO方法从完整的响应所带来的优势开始,并将其重新分配到代币中.重分布不均.它取决于每个代币有多自信以及总体反应是否被评为积极或消极.
对于负优势的响应,EAPO对低.令牌分配更强大的惩罚.这些是模型最确定的令牌.当一个自信的令牌与失败的推理路径联系在一起时,集中罚款针对可能重复的行为.目标是纠正反复出现的故障,而不是平等地惩罚整个反应.
对于积极优势的响应,EAPO将更大的信用分配给高.代币.这些是模型不那么确定但仍然有助于产生成功答案的代码.在那里给予信贷加强了探索.它告诉政策,一个不确定的分支可能很有价值,而不仅仅是安全的分支可以接受.
EAPO还减轻了不确定的位置的处罚.这保护了模糊而不是明显有害的代币.在推理中,这些代币可能成为转折点,允许模型从以前的错误中恢复过来.通过软化不确定性高的地方的惩罚,该方法保留了回收机会.
最新:三项规则定义了EAPO更新
该方法可以通过三个关联的规则来总结.首先,负优势响应中的低代币获得更强大的处罚以纠正反复失败;其次,积极优势反应中的高代码获得更多信用以加强勘探;第三,在不确定的位置上的惩罚被减弱以保持恢复机会.
这些规则将.置于代币级信用分配的中心.所述贡献是一种训练机制:它塑造了政策优化如何在LLM推理培训期间处理不确定性.
目前的情况及注意事项
目前EAPO正处于一个新引入的框架阶段,用于在LLM推理中以为导向的信用分配.该方法解释了优势值应该如何跨令牌移动,但更大的问题是当训练较长的推理链和更复杂的勘探政策时,这种代币级权重如何发挥作用.需要关注的是不确定性意识的信贷分配是否可以成为减少反复自信错误的实用方式,同时保持有用的探索分支活动.
Comments
No comments yet. Be the first to comment.