
重复自动语音相似性评估:从相同的错误率到 embedding 几何
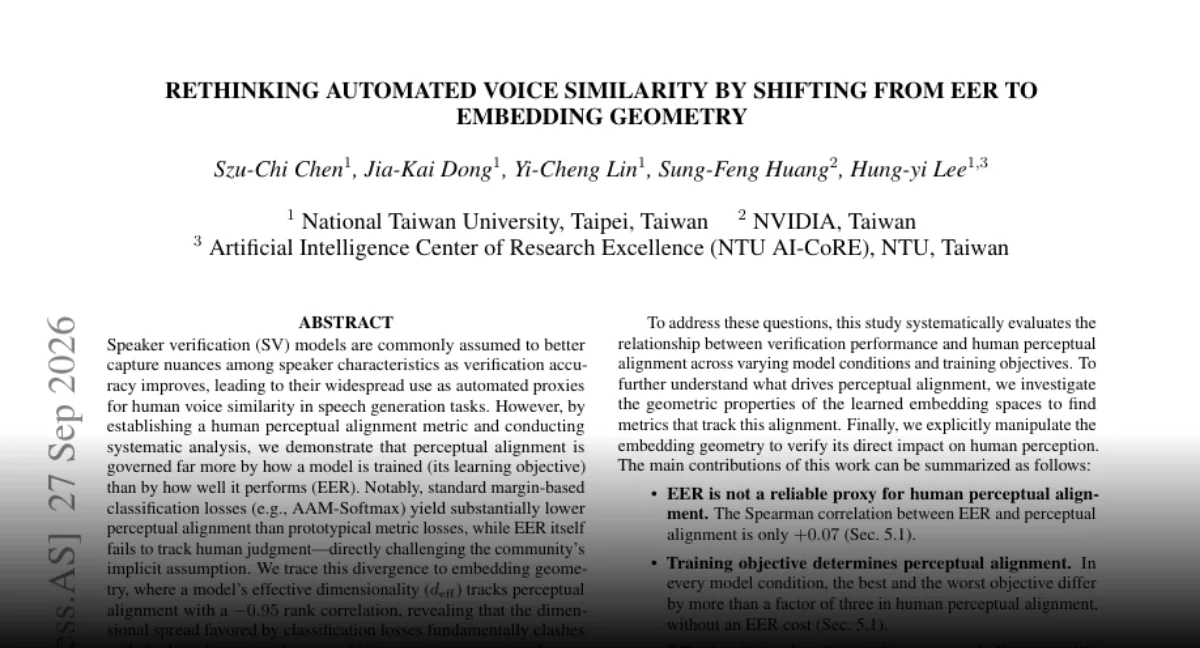
扬声器验证模型经常被用作人类声音相似性判断的自动代理.这项分析表明,训练目标和 embedding 几何学比EER更好地预测知觉对齐.基于边际的损失 (如AAM-Softmax) 可以产生 embeddings 在几何上紧.但与人体感知不太一致的数字,而原型的度量损失和较低的有效维数可以提高对齐率.结果表明语音相似性的评估应该评估 embedding ,形状和训练方法,而不是 JUST 验证准确性.
主要内容
- 作为语音相似性代理使用的扬声器验证模型更多地通过训练目标和 embedding 几何而不是Equal Error Rate与人类感知保持一致.
- 基于边际的损失,如AAM-Softmax可以产生比原型度量损失更低的感知对齐,即使验证准确性很强.
- embedding 几何是关键:有效的维度d_eff跟踪感知对齐与-0.95等级相关性,表明人类声音感知依赖于低维结构.
- 强加一个维度瓶可以改善感知对齐, ρ_align从0.08增加到0.74,为评估语音相似性提供了超越EER的几何标准.
超级描述:作为语音相似性代理使用的扬声器验证模型更多地通过培训目标和 embedding 几何而不是EER与人类感知保持一致.
标签:扬声器验证,语音相似性 embedding 几何学AAM-Softmax发言生成
主要图片:抽象的波形格子和低维向量空间,柔软的蓝色和紫色调,没有人,没有标志,没有文本
AAM-Softmax 减少声音对齐作为d_eff轨道 -0.95相关性
扬声器验证 (SV) 模型已经成为人类在语音生成任务中对声音相似性的判断的常见自动替代品.系统分析挑战了这种习惯:它表明,如何训练一个 SV 模型,而不是它的标题验证准确性,更密切地跟踪人体感知调整.这一发现很重要,因为当听力测试昂贵时,通常使用 SV 分数作为方便的代理程序,看起来精确的代理仍然可以不同意人们所听到的内容.
背景:为什么SV模型被用作人类法官
SV系统通过将录音转化为 embeddings 的向量表示来对声音进行比较,以总结说话者特征.等错率 (EER) 通过找到虚假验收和虚假拒绝相同的操作点来衡量验证准确性.随着 EER 的改进,该领域普遍认为更好的验证意味着更好地捕捉扬声器细微差别.这一假设有助于扩大使用SV模型作为语音生成任务中人类声音相似性的自动代理程序.
这种假设也反映了实际压力. 人类对合成或转换语音的评估是昂贵,缓慢和主观的. 一个可以自动得分相似性的模型对于开发循环,基准测试和大规模测试具有吸引力. 问题在于确定"相同发言者还是不一样"的精度是否与产生符合人类感知的相似性评分是一样的.
发展过程:培训目标,而不是EER
该分析建立了一个人类感知对齐指标,并将其与传统的绩效衡量标准进行比较.该分析发现,感觉对齐受到学习目标的影响远大于模型在EER上的表现程度. 基于边际的标准分类损失 (如AAM-Softmax) 比原型度量的损失要低得多.
基于边际的损失侧重于区分具有明确决策界限的类,而原型度量损失则围绕演讲者或类的代表点组织 embeddings .这种比较直接挑战了社区隐含的假设,即验证准确性和人类感知相似性一起提高.EER本身无法跟踪人类判断,因此两种具有类似验证得分的模型可以支持关于语音相似性的非常不同的判断.
最新进展:几何学解释了不匹配
这项研究将这种分歧追溯到 embedding 几何学,即高维空间中的扬声器向量的形状和分布.一个模型的有效维度 (d_eff) 跟踪了与-0.95等级相关性的感知对齐.这种强大的关系表明当 embeddings 占据较小的有效尺寸结构时,人类-感知對齐变得更加可预测.
分类损失倾向于有利于维度扩散,而人类声音感知似乎依赖于更低的维度结构.这种不匹配解释了为什么具有强大的验证准确性的模型仍然可以产生与听众错位的相似性得分.几何计算将训练选择观察转化为 embedding 空间的一个可测量的属性.
当前阶段:瓶证据和注意事项
强加一个维度瓶压缩d_eff并提高感知对齐.报告的指标 ρ_align 从0.08移动到0.74.该结果建立了评估语音相似性的原则性几何标准:超越EER,检查模型使用多少有意义的尺寸来表示扬声器身份.
这项研究将该领域置于一个可以通过其几何和准确性来判断语音相似性代理的位置.接下来要关注的是基于维度的诊断是否在语言生成评估中成为常规,以及进一步的研究是否证实了d_eff, ρ_align与不同损失函数和 datasets 之间的人类感知之间的联系.
Comments
No comments yet. Be the first to comment.