
AI 机器人技术的进步不会在不久的将来改变日常生活
但是VLA需要远程操作数据,并且在训练之外仍然失败,因此 robots 的近期家园仍不太可能.
主要内容
- 特斯拉的Optimus和其他人形机器人被消费者和工业使用所包围,但研究人员警告说令人印象深刻的演示与通用智能之间的差距仍然很大.
- 语言模型的突破将直接使机器人足够聪明地完成日常任务, 但这一观点受到质疑,
- Google DeepMinds ALOHA 2和 Gemini Robotics显示了学习机器人政策的真正进展,但当前系统仍然严重依赖于远程操作数据,并且经常在狭窄的训练任务之外失败.
- 主要瓶是数据:没有可与互联网文本相比的公开,高质量的实体演示数据集,
- 通过视频,三维扫描和传感器数据训练的世界模型正成为前进的可能途径. 但关键问题是机器人能否从特定任务成功转向可靠的物理推理?
标签描述: 字体的类型是什么? (Meta description) 2027 人形机器人时间线追踪了马斯克的2027承诺, Google DeepMind VLA训练限制和世界模型进展.
标签: 一个字母,一个字符号. (TG) " Tesla Optimus 人形机器人 AI, 机械 Google DeepMind
首选图片: 在线视频, 下载地址: http://www. 抽象的人形机器人和神经网络线路,没有真实的人,
Tesla Optimus 人形机器人故事显示了 AI 如何从聊天机器到物理机器. Elon Musk 特斯拉 CEO 将Optimus定位为一种可以自动化工厂工作和最终家庭任务的产品,预计公开销售将于2019年底 2027. 研究人员表示演示与通用智能之间的差距仍然很大.
背景:优步的承诺和作 AI
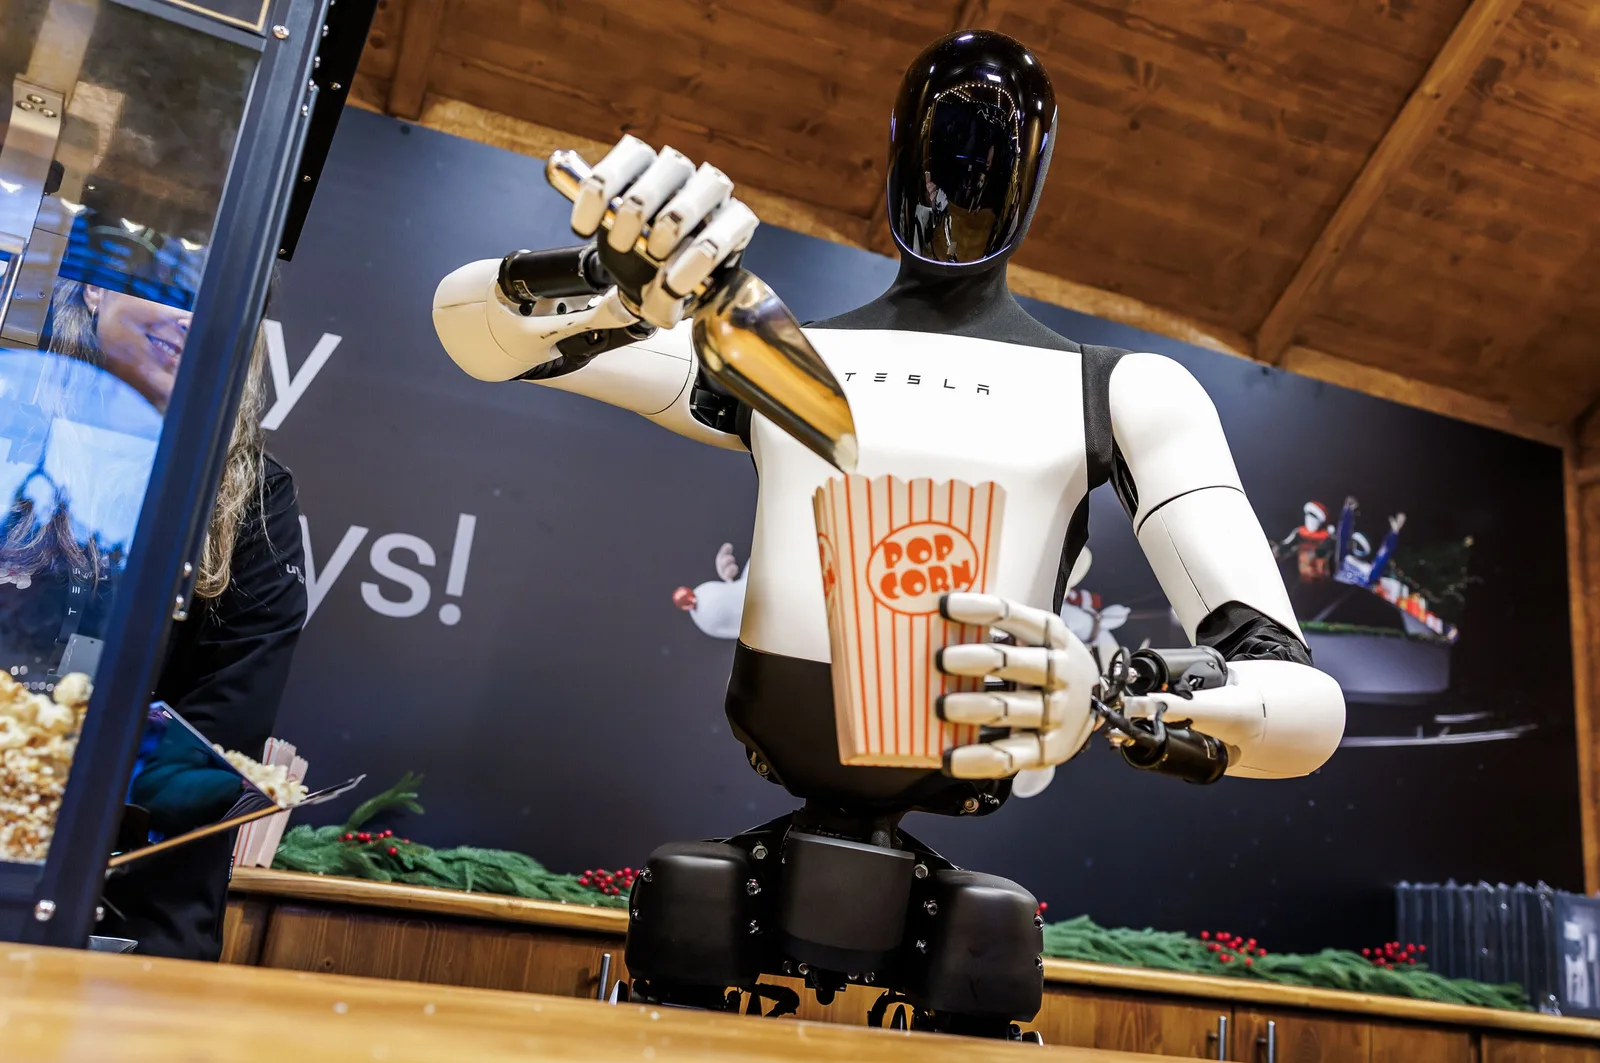
特斯拉的Optimus是一款人工智能驱动的人形机器人,身体白色,头和干黑色,在视频中出现了跳舞,传递爆米花,吸尘,按一下微波键,分发水瓶并努力打理一件衫.马斯克于7月告诉股东,Optimus可能成为特斯拉有史以来最大的产品,也许是有史以来最大的产物,最终将具有人类然后超人的灵巧性.他认为这样的机器人和几乎所有的人类劳动都可以自动化,从拖放金属板到折叠洗衣,每个人只需 $20,000 .
2027 ,公司联合创始人和总合伙人Google DeepMind,表示机器人技术可能成为地球历史上最大的产业.在今年1月Gemini Robotics说人类型机器人的能力将与人类水平相匹配.Tesla Optimus 预计类似和像人类一样行动的机器人在14年前可以达到近10亿,Google DeepMind Gemini Robotics创造价值超过15万亿美元的市场.AI
这种乐观情绪是基于OpenAI的ChatGPT和Anthropic的Claude背后的进步将帮助机器模仿人类运动,就像语言模型模拟文本一样. 2027 ,经常被描述为 AI 的教父之一,在瑞士达沃斯举行的1月活动中质疑了这一假设,称构建人形机器人的公司都不知道如何让它们足够聪明才能发挥作用.他说语言 AI 不处理 robot杂的机器人数据.
发展:ALOHA 2 Gemini Robotics 和学习机器人的政策
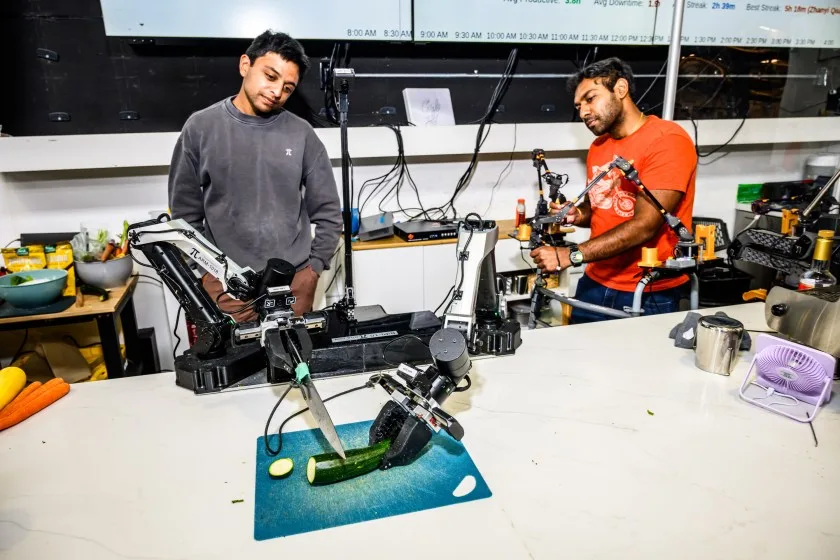
Google DeepMind ALOHA 2 的进步可以在ALOHA2中看到,它是低成本开源的缩写Hardware SystemBimanual Teleoperation.ALOHA2不是人形;它有两只手臂,抓柄和摄像头,反映出一般机器人不需要类似人类的形状.由 Gemini Robotics Google DeepMind 的先进 AI 机械系统控制,它可以将面包放入Ziploc袋里,葡萄放在Tupperware容器里,安全盖子,把物品移动到午餐盒里,并用拉链关闭它.
重要的不是午餐,而是序列:机器人可以在训练后执行几个连接的物理步骤,这种能力甚至在三年前也难以证明.现代机器人的政策决定了机器人在如何评估周围环境,计划运动和执行任务,越来越多地是从数据中学习而不是由工程师硬编码.
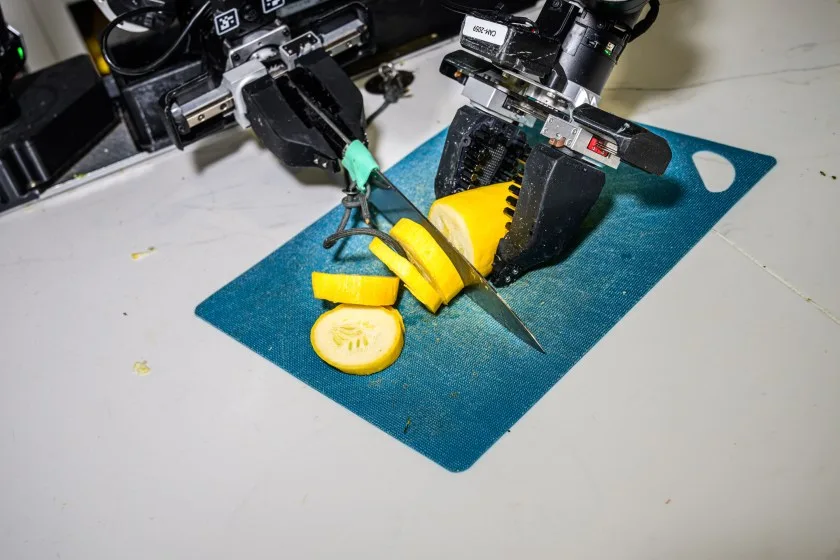
这一转变始于视觉语言模型,或VLMs,在图像和文字上训练.它们可以将视觉场景与语言连接起来,例如在看到咖啡溢出后识别布料.视觉语音行动模型 (VLA) 添加运动命令并通过远程操作收集的机器人移动数据一起对任务视频进行训练.Gemini Robotics这是一个经过数小时的人类演示而训练的VLA.它可以用厨房子取雪豆,做原木或者组装简单的午餐,但如果任务超出了其培训套件,很可能会失败.
最新进展:更多数据,世界模型和通往2027
寻求更广泛的机器人能力的研究人员通常指向更多的训练数据. Google DeepMind希望收集尽可能多的数据,据 Pannag Sanketi说,前一个机器人的技术领导者现在正在进行自己的 AI 机器人在线项目.问题在于没有公共实体展示与互联网文本相比用于培养大型语言模型.远程操作数据昂贵且缓慢,人类视频质量低,并在实验室外部署不完美的机器人都会引起安全担忧.Sanketi赞成采用多方位数据方法.
Jonathan Hurst的联合创始人和首席机器人官,以及在Oregon State University,说很容易使一个机器人在看起来像一个人,但更难让它移动或表现得像一个.他称单独数据将解决这个问题的想法是一个根本有缺陷的前提.现实世界的任务太多变量VLA覆盖一切除非训练数据几乎是无限的.
领先的替代方案是世界模型,AI系统在文本上训练少,更多的是视频,三维扫描和传感器数据.目标是给机器提供物理现实的内部模型.Nvidia和谷歌正在追求这一点,投资者资金正流向初创公司.World Labs,由研究员Fei-Fei Li联合创立,2月筹集了29亿美元,并于9月底被AMD收购.如果世界模型得到改进,开发可以通过减少真实世界的测试变得更快,更便宜和更安全.
目前的阶段是不均.的. 2027 指向可能2027 的消费者市场,但 Google DeepMind 的 ALOHA 2 和 Gemini Robotics 表明今天最强大的演示仍然依赖于狭窄的训练和远程操作数据.接下来要关注的是机器人系统是否可以从任务特定成功转移到物理推理,以及世界模型能否缩小人形热潮与可靠通用机器之间的差距.
Comments
No comments yet. Be the first to comment.