
AI名特工可以从照片中重建3D场景, 但无法判断它们是否准确
乐高-任何东西都能将照片转化为可编辑的混合器场景, 但基准显示模型构建可用的3D布局很糟糕并误判自己的工作.
主要内容
- 乐高-任何东西通过代代理循环将单一照片转换为可编辑,可执行的混合器代码来呈现,检查和修改场景.
- LEGO-Bench使用模拟器场景中隐藏的地面真相,评分有效性,几何重建和外观来评估这些系统.
- 目前的代理商通常会制作可用的场景,但其几何准确性较弱,并且他们经常无法对修改是否能改善他们的产品进行可靠判断.
- 一个没有培训的LEGO插件通过对参考图像进行定,使用可测量的信号而不是自我评估和防止回归来改善结果.
- 基于代码的重建仍然很有前途, 但仍落后于专业视觉模型,
一项名为LEGO-Anything的研究已经展示了一个"图像到代码"管道,其中一个编码代理查看一张照片并写出可执行的混合器程序来重建场景.由于输出是代码而不是静态网格,因此结果可以运行,检查,编辑和对下游图像分析任务进行查询.
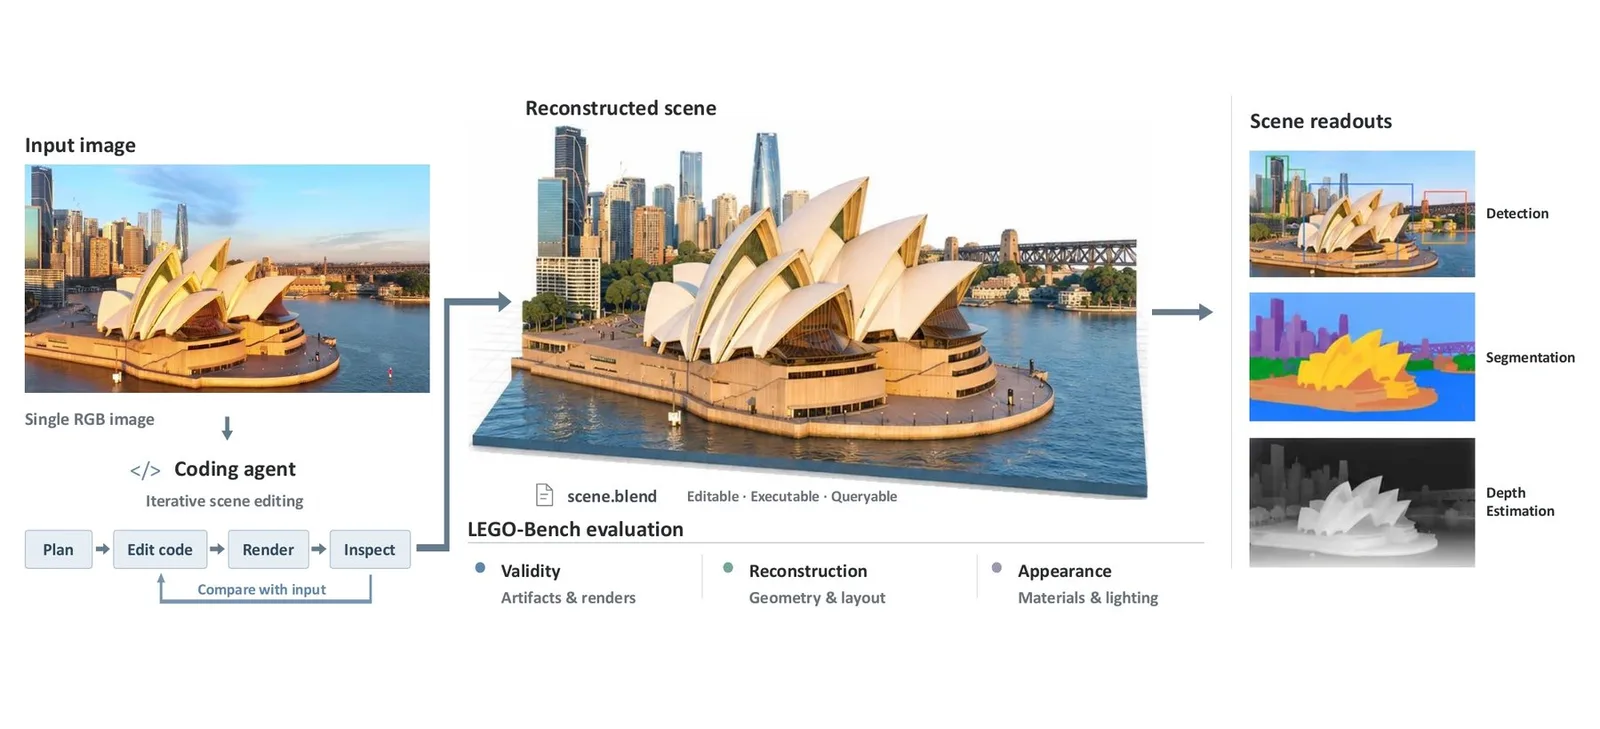
工作流是代的,而不是一次性的.代理人起草代码,在混合器中执行它,检查染结果并修改直到重建接近源图像.这个循环很重要:程序明确编码对象,几何形状,布局和摄像头位置,因此用户可以将这些元素修改为任何其他脚本的方式.
背景:为什么需要一个基准
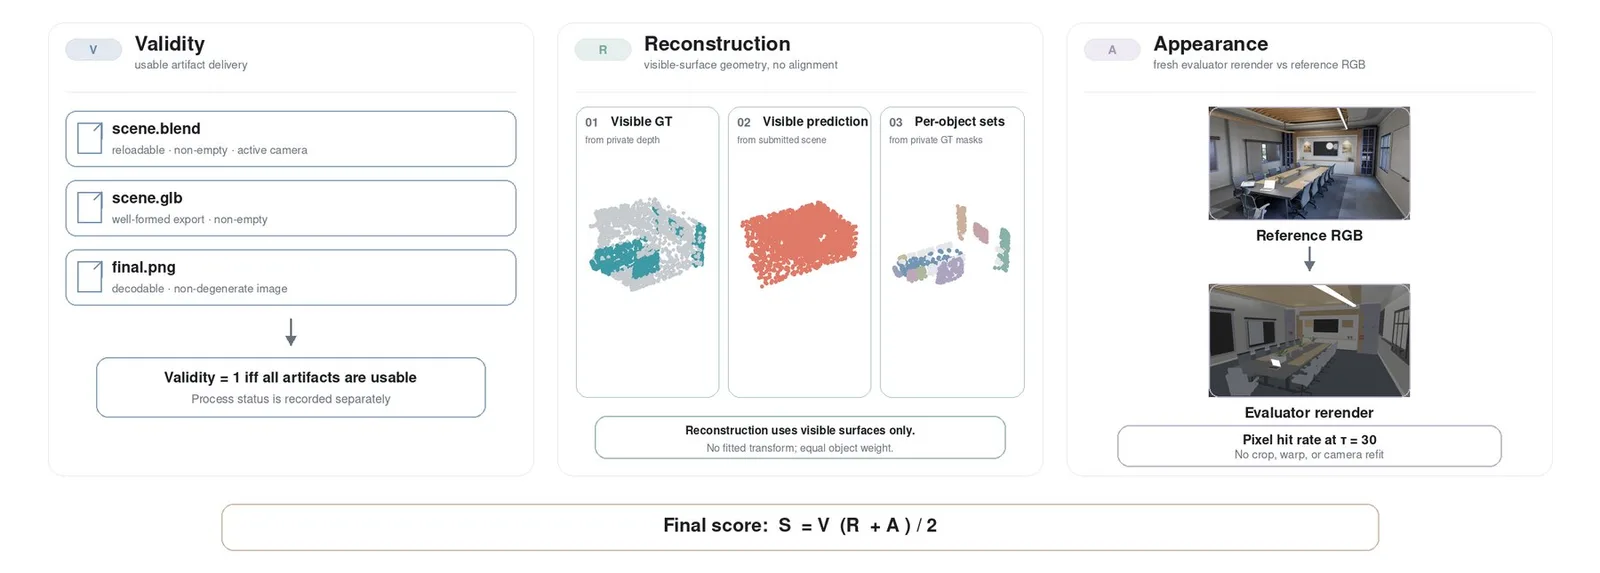
评估这种系统很尬.真实的照片没有精确的3D地面真理,而简单的合成场景往往看起来是人造的.该团队的答案是乐高板 (LEGO-Bench),由专业编写的模拟器场景构建.它包含来自104个室内和户外场景的208张图像,并依赖于443个注册资产.
模拟器场景的染使得输入看起来自然,而确切的几何形状,深度和对象分配则隐藏为自动评分的答案密钥.复杂性可以在不改变照明或摄像头设置的情况下扩大.每个场景根据三个轴进行排序:有效性 (是否提供了可用的文物),重建 (可见几何体是多么准确) 和外观 (与参考相比重新染后的像素比较).
发展:强大的有效性,弱的几何学
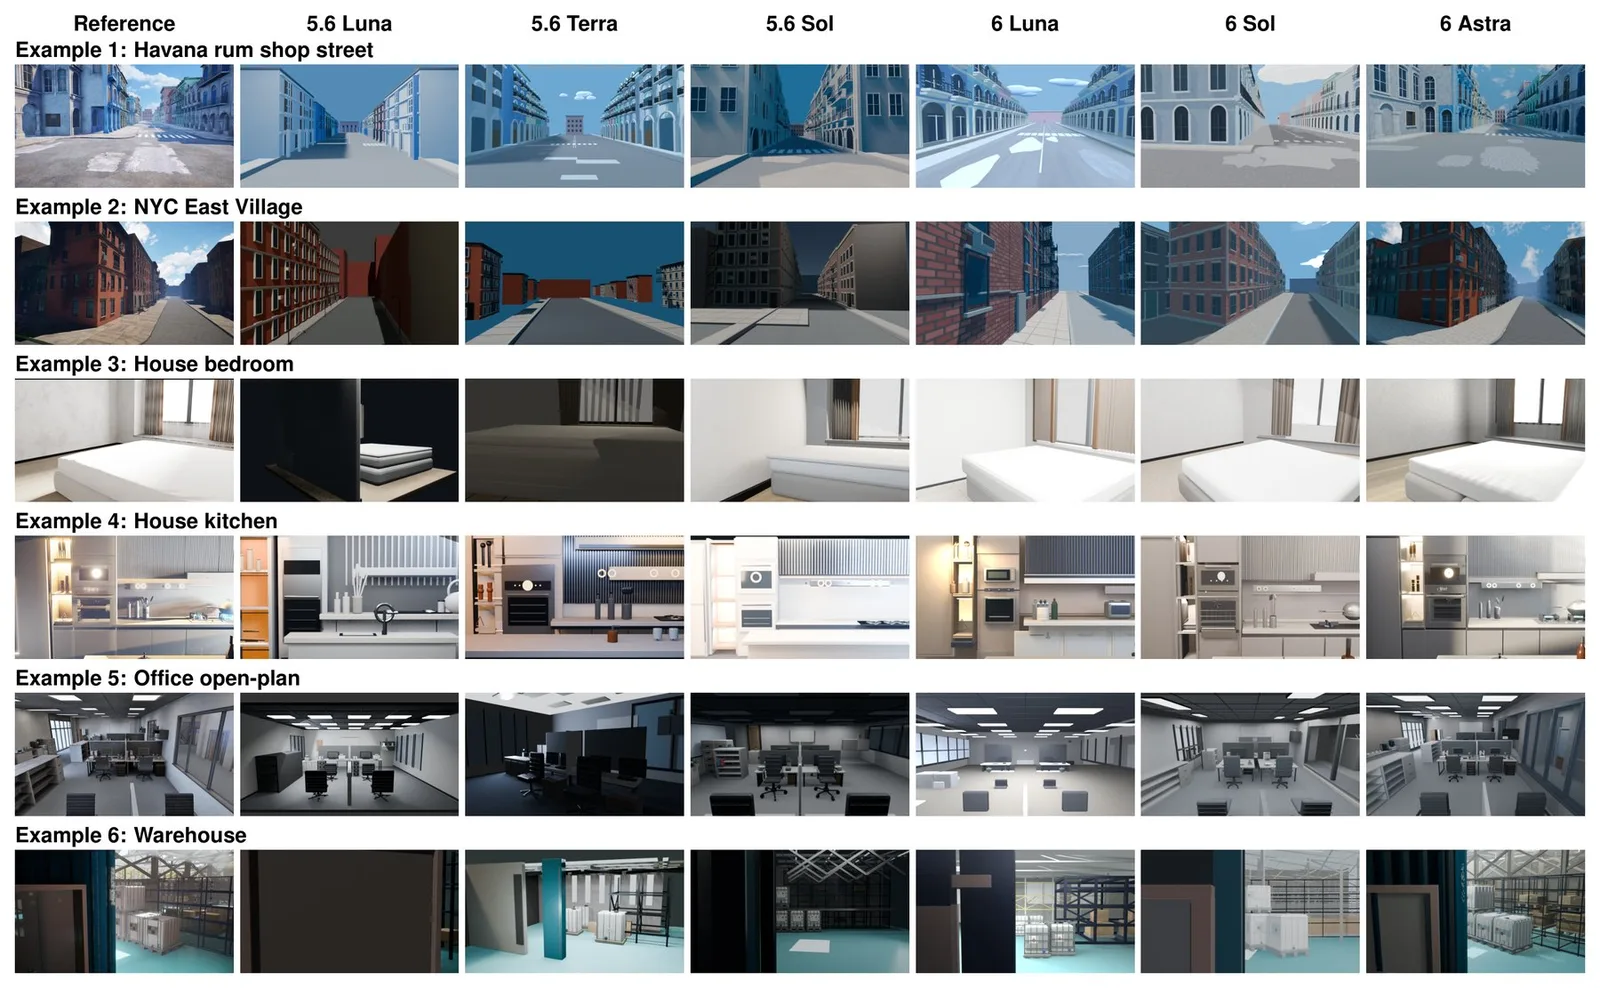
所有六种测试的GPT配置几乎每次都会产生一个工作场景,但准确性差异很大. GPT-6 Astra是最强大的配置,在室内场景中达到 53.4%和 39.6%在户外场景;较弱的设置接近15%. 难度与场景复杂性的比例相比,外部显示比内部更困难.
增加推理预算有助于GPT-6变体.Astra在办公室测试子集的得分从 32.3升至 61.8%.阶段级分析确定了反复出现的故障模式:初次尝试较弱,修订回滚早期收益和不可靠的自我评估.
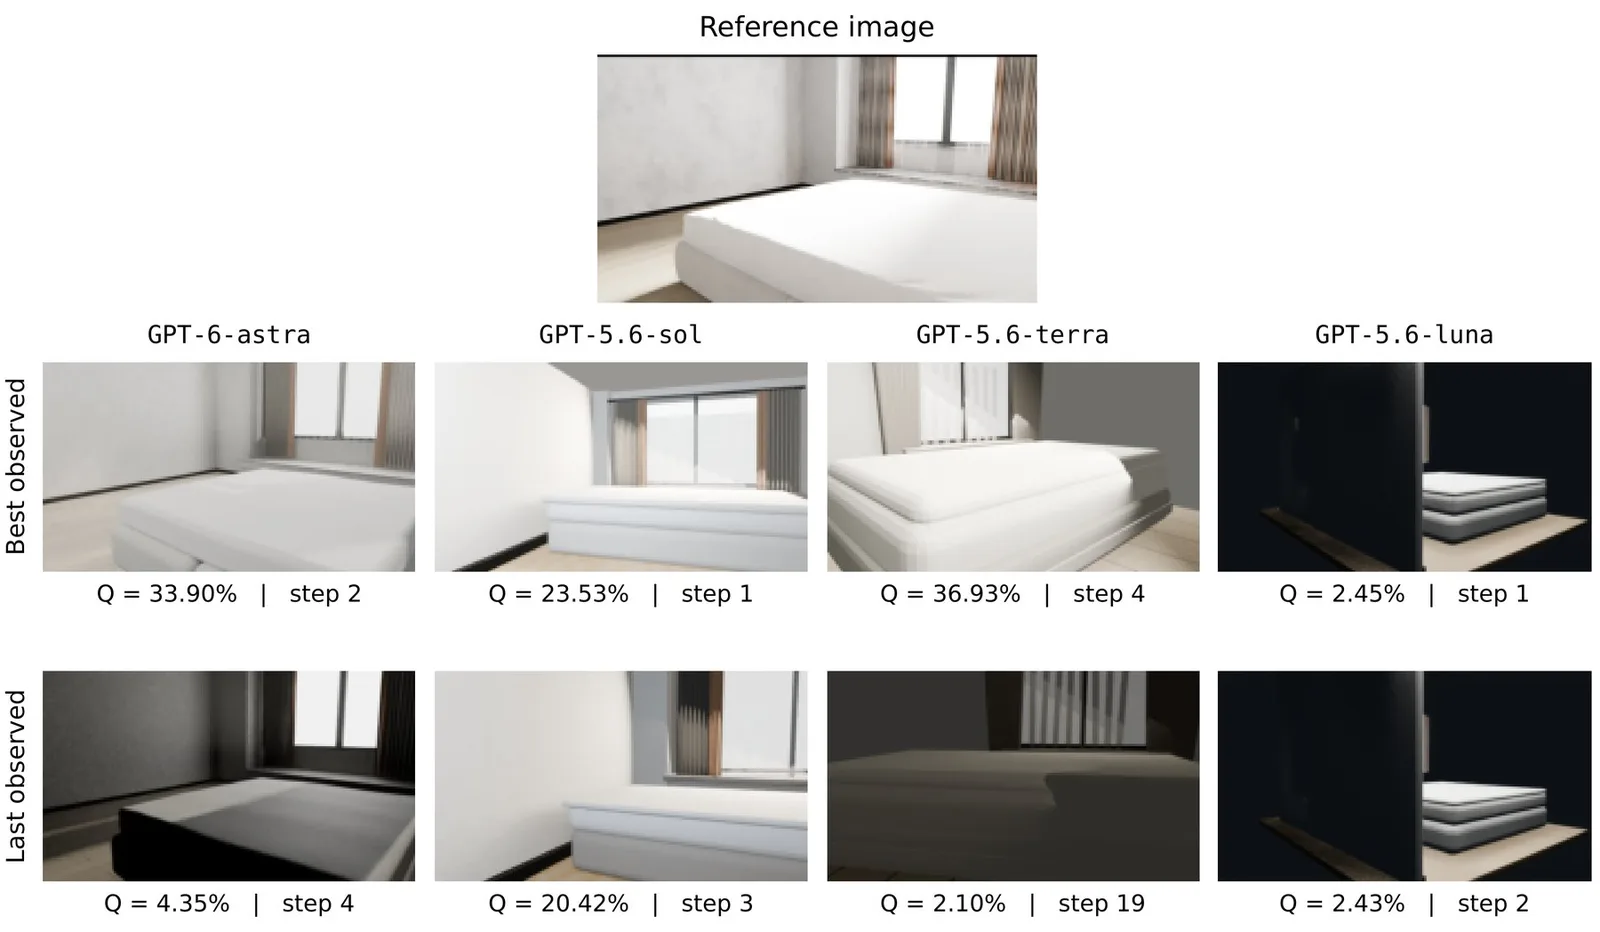
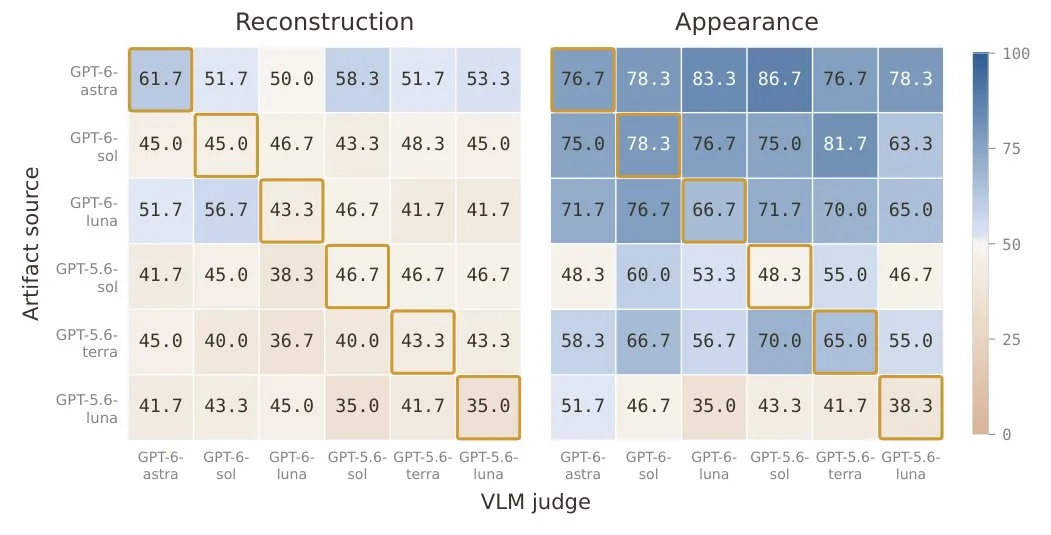
最后一个问题是最重要的.当被要求选择两个版本中哪个更符合原始时,模型在几何判断上得分接近或低于机会 - 代理人实际上无法告诉自己的场景是否有所改善 Even GPT-6 Astra 在运行晚些时候降低了自己的输出,从 33.9 到 4.4 % .作者认为改进必须依赖具体测量而不是代理人的个人意见.
最新进展:一个免训练的插件
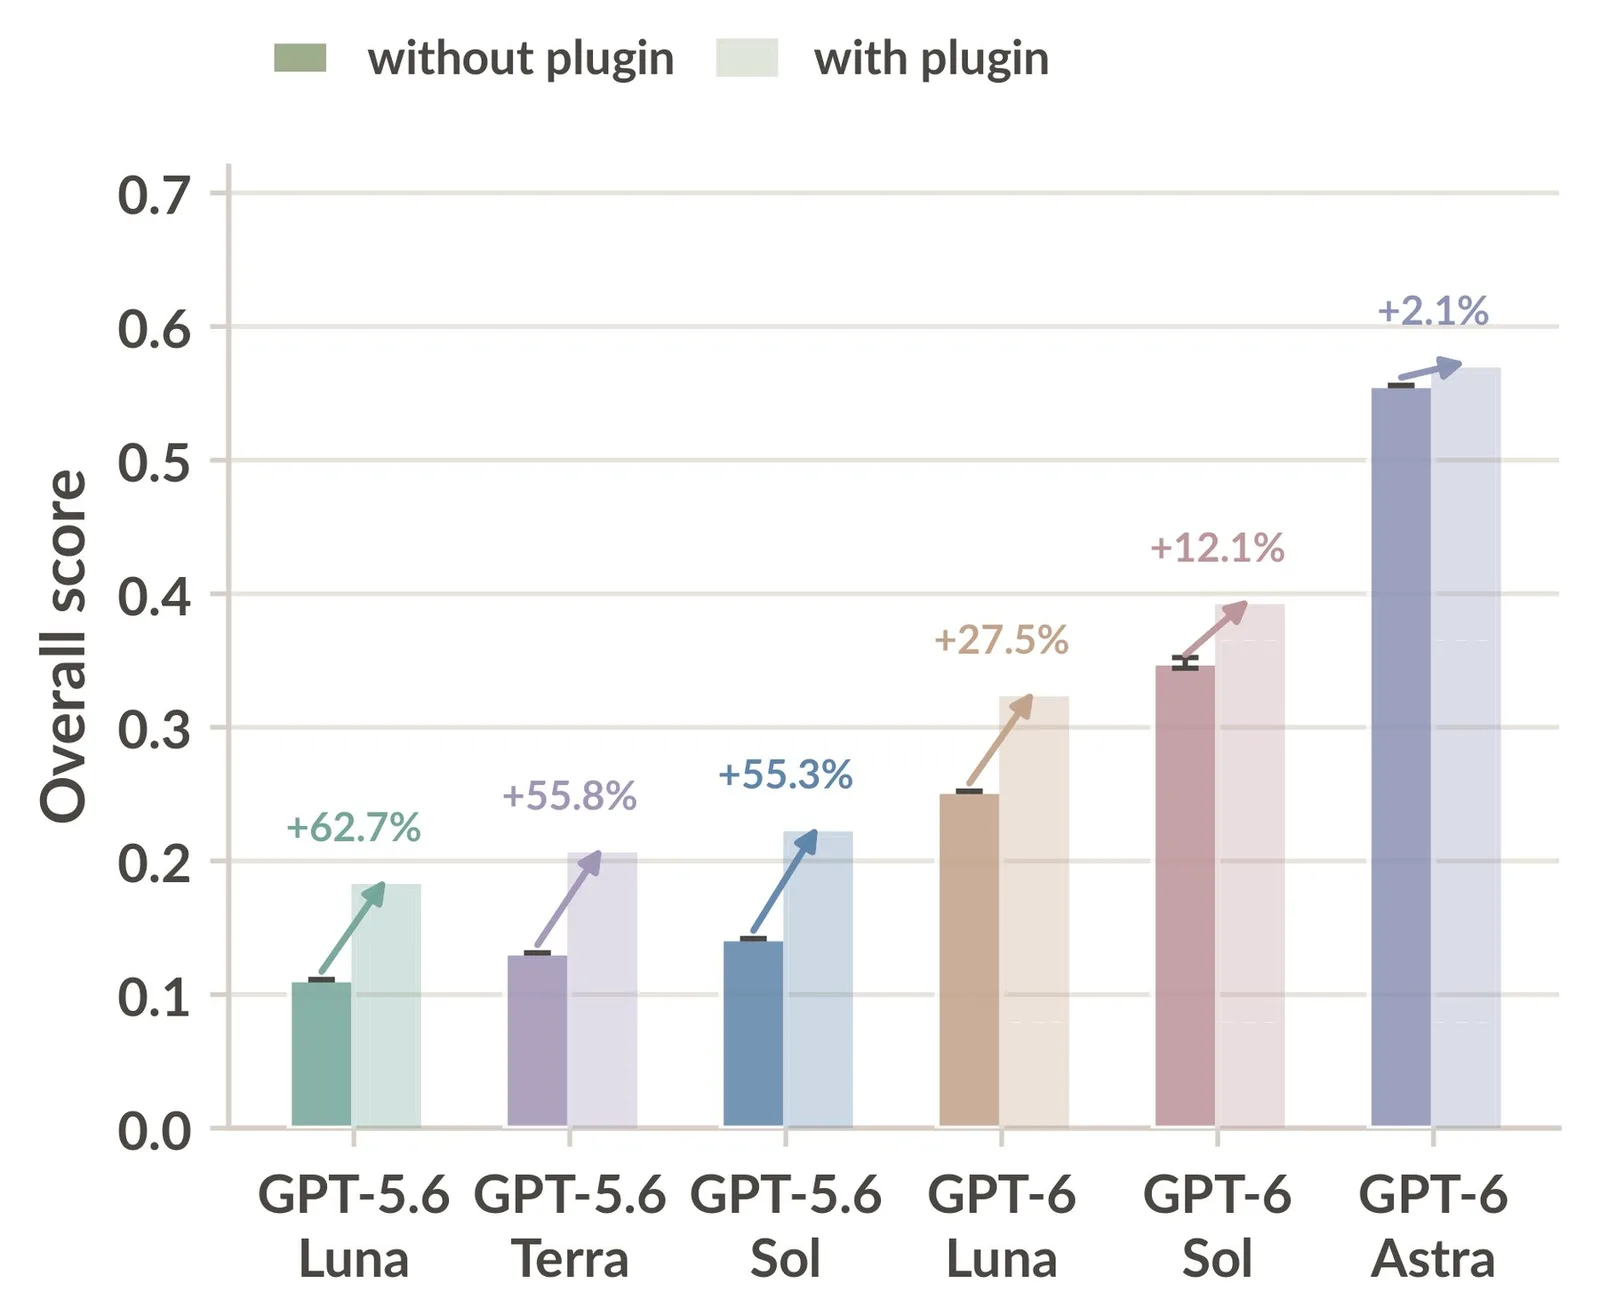
这一发现产生了LEGO-Plugin,这是一种不需要额外训练的扩展.它将起始场景固定在参考图像上,用可测量的信号取代不可靠的自我判断,并保护正确的进度免受回归编辑.所有六种模型都得到了改进.较弱的代理获得了最大的收益,增幅高达8%,而已经强大的顶级模式增加了大约2个百分点.
该团队还测试了重建的场景是否能够支持标准视觉任务,因为对象检测,细分和深度估计可以直接从可执行程序中读取.没有额外的训练,结果是可用的但不显著. 检测最接近,达到专业模型 DINO 的一半性能;与 SAM 3 和 Depth Anything 3 的差距在分割和 深度方面更大. 作者将当前编码代理描述为有希望但尚未足够准确,工作结果和忠实重建之间的距离很远.
需要注意什么
Astra的指挥式LEGO-Bench引领符合更广泛的模式.AI研究人员Yoav Artzi将该模型视为空间理解的一个重要步骤,并怀疑对像Blender场景等大量3D数据进行训练. 工具正在平行移动:Unity已经发送了 Claude Code和Codex的官方插件.替代路线完全避免编码World LabsWorld Labs在其Atlas世界模型内重建场景,而 Google DeepMind的GenCeption则使用与专业模型相匹配的深度估计和细分的视频模型.开放的问题是测量驱动的改进是否能比端到端世界的模型更快地缩小几何差距,从而使基于代码的重构不必要.
Comments
No comments yet. Be the first to comment.