
SanSi:用于系统1.5思维的代类型决策模型
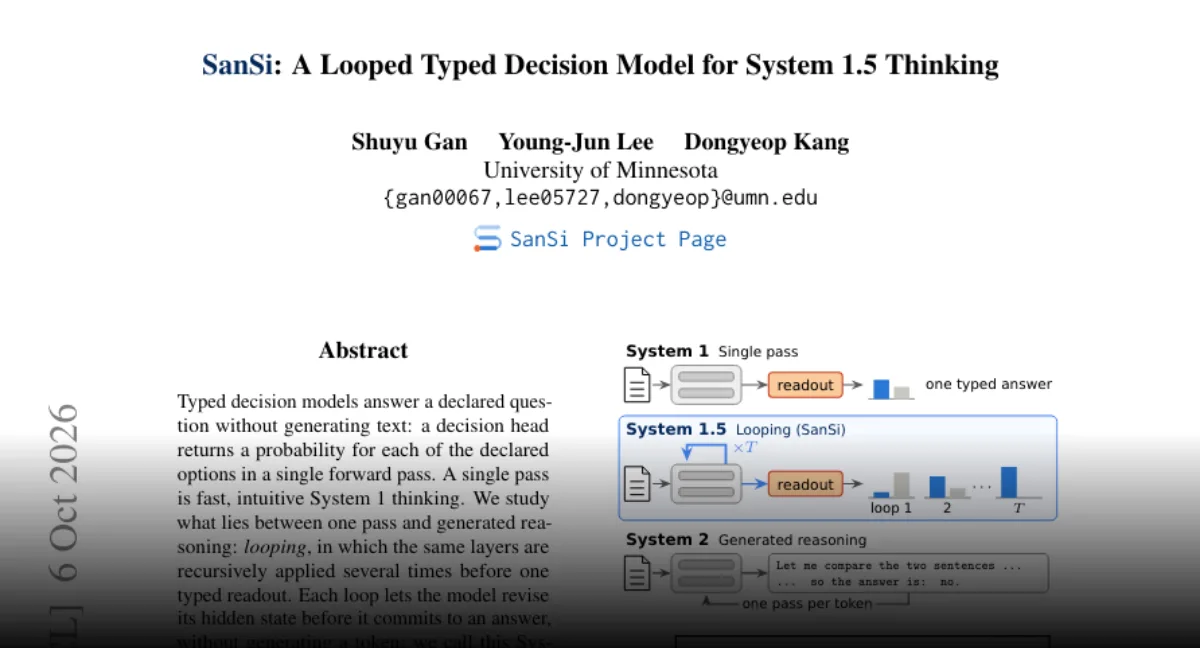
SanSi 1.4B 通过八个循环提炼选项概率,避免推理 tokens ,并且在报告任务中处于 Qwen3.5-4B 的1.8 点之内.
主要内容
- SanSi 1.4B是一个小循环类型的决策模型 ,它输出了声明选项的概率,而不是生成自由形式推理 tokens .
- 它的八环设计允许在任何循环后读取结果,创建一个早期退出机制并使得推断成本由循环数而不是答案长度控制.
- 报告的模型在相同数据和训练配方下与Qwen3.5-4B缩小了1.8点的差距,这表明架构和输出格式优势而不是仅规模.
- SanSi被描述为处理比训练中看到的更长的推理链,指出重复决策改进作为灵活推理深度的潜在来源.
- 目前的报告提供了一个早期信号; 需要进一步验证任务范围,选项定义,评估细节和实际部署预算行为.
标签描述: 字体的类型是什么? (Meta description) SanSi 1.4B循环决策模型与Qwen3.5-4B关闭了1.8点的差距,通过在没有推理 tokens 的情况下读取任何八个循环后的概率.
标签: 一个字母,一个字符号. (TG) " SanSi,Qwen3.5-4B,循环类型决策模型,灵活的推理计算,小语言模型
首选图片: 在线视频, 下载地址: http://www. 通过八个节点循环的光决策图, 没有真实的人,
SanSi 1.4B,是一个循环类型的决策模型,被描述为一个小模型,它返回每个声明选项的概率,并且可以在任何八个循环后读取而不会产生推理 tokens . 在报告中的比较中,它使用相同的数据和配方达到Qwen3.5-4B的1.8点之内,并将其描述为解决训练中见过的更长的推理链. 结果很重要,因为它重新构建了一个熟悉的权衡:这项工作不仅依赖于更大的模型或更长文本答案,而是探索重复决策计算作为灵活性来源.
背景:为什么选项概率会改变计算故事
小型语言模型通常在固定的参数预算下运行,如果一个模型产生中间推理 tokens ,答案路径可能会增长.对于需要定义选项中的选择的任务,很长的自由形式答案可能不是最有用的输出.返回声明选项概率的模型可以更容易解析,更容易与一组固定的选择进行比较,并且在部署中更加可预测.SanSi描述将这个想法置于循环架构内:该模型不仅发出一个最终答案;它反复改进决策,结果可以在不同的循环深度上读取.
发展:从一次性答案到八个可读循环
循环类型决策模型是围绕三个具体元素构建的.首先,任务通过声明选项来表达,因此该模型返回每个选项的概率.其次,计算被组织成八个循环.第三,在这些循环中的任何一个之后可以读取该模型,从而创建了一个早期退出机制.呼叫者可以在较短运行后采取可用的决定或等待完整的八循环路径.由于该模型不会产生推理 tokens ,推断路径是由循环数而不是中间文本长度所塑造的.结构也给定了最大路径:八条循环 .
最新的进展:SanSi 1.4B缩小距离到Qwen3.5-4B
标题数字是差距:据报道,SanSi 1.4B在Qwen3.5-4B的1.8点之内.比较被描述为使用相同的数据和配方,这表明架构和输出格式作为感兴趣的变量而不是不同的训练混合物.参数名称将两种模型放在1.4B和4B尺度上,因此1.8-point结果表明循环决策模型可以恢复报告任务中的大部分差异.第二个细节是关于推理深度.该模型被称为解决比任何培训中见过的更长的推理链.这提出了这样一个问题:是否重复选项级决策能够扩展模型的可用推理路径而不需要更长时间的培训链?
当前阶段:报告确立了什么,还有什么待观察
在这个阶段,可用的报告提供了一个明确的早期信号而不是一个广泛的基准程序.它确定1.4B SanSi模型可以使用八个循环,返回声明选项的概率,避免生成推理 tokens ,在Qwen3.5-4B中的1.8点内进行处理,并且比训练中看到的更长的推理链.下面的检查是任务集,声明选項的定义,1.8-点差距背后的评价细节以及八阅读路径是否在不同的部署预算下表现得一致.
Comments
No comments yet. Be the first to comment.