
A reinforcement learning 关于 OPD 的观点:为样本效率的最小正方形政策蒸 LLM推理
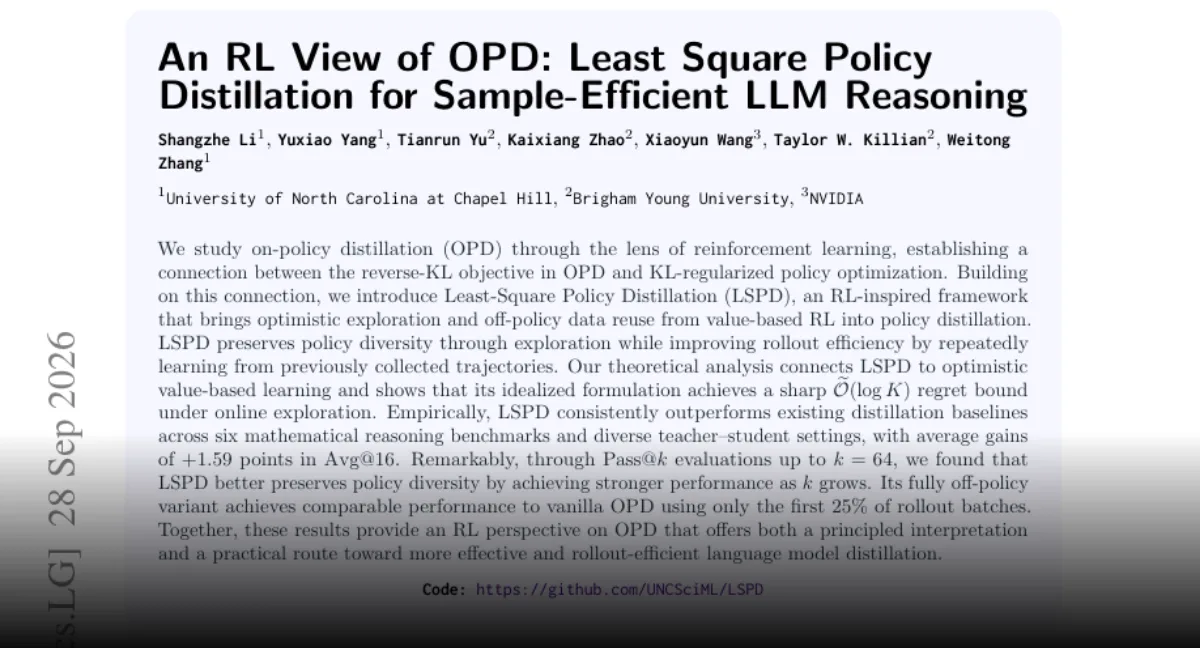
LSPD将政策蒸.改为KL规范的RL,使用最小平方匹配和重复来提高样本效率LLM推理.
主要内容
- LSPD将 LLMs 的政策蒸.重新定义为KL规范化的 reinforcement learning 问题,允许学生模型重复使用积累的经验而不是仅依赖于新推出.
- 而不是标准的政策梯度更新,LSPD通过匹配教师和学生日志概率以最小平方目标来训练学生,而基于重复的变体 LSPD-RB 使用大约四分之一的推出批量实现了与香草OPD相似的性能.
- 在6个数学推理基准和3个教师-学生设置中,LSPD提高了推理性能和多样本解决方案覆盖率,这意味着该模型探索了一组更广泛且更有用的可能答案.
- 这项工作表明,LLM名教师和学生的培训可以借用基于价值的RL技术,如经验重复,乐观估计和最小平方回归来提高样本效率并降低推广成本.
- 目前,LSPD和LSPD-RB是对数学推理任务进行验证的研究方法,尚未被证明可以替代所有蒸.管道.
标签描述: 字体的类型是什么? (Meta description)
LSPD将政策蒸.重新定义为KL规范的 reinforcement learning ,使用最小平方匹配来削减LLM推广批次.
标签: 在政策上蒸, LSPD, reinforcement learning , LLM推理, 样本效率
首选图片:抽象的技术风格,显示教师网络指导学生网络通过最小平方目标,没有真实的人物,没有公司标志和文本.
Least Square Policy Distillation,或LSPD,将语言模型的政策蒸.重新定义为一个可以重复使用积累经验的 reinforcement learning 问题.据报道,其基于重播的变体LSPD-RB与大约四分之一的推出批量匹配了香草政策蒸 ?? ,而更广泛的方法提高了六个数学推理基准和三个教师学生设置中的推理性能和多样本解决方案覆盖率.
背景:在政策上蒸已经具有RL视角
在政策蒸. (OPD) 常用政策渐变更新来实现:学生模型生成样本,教师模型提供反,并将学生更新为老师喜欢的行为.目标通常是逆KL分歧,这是衡量学生下一个- token 分布与老师之间的距离的一种指标,写在该方向上惩罚了老师认为不太可能的学生选择.这篇论文的起点是,这种逆 KL目标也有一个准确的解释,即 KL-规范 reinforcement learning .在这一表述中,奖励是由老师相对于参考策略定义的,而 KL术语控制着学生从产生经验的政策走出多远.这一关联很重要,因为基于价值的 reinforcement learning 长期以来与积累的经验学习有关,而在政策偏差更新时经常会邀请新人花费,因为他们正在收集新的框架?
发展:LSPD将教师的反转化为最小平方目标
LSPD改变了学习信号.它不仅使用教师反来驱动政策渐变更新,而是通过强大的最小方程目标直接匹配学生和老师日志概率.日志几率是分配给每一个接下来的 token 的概率的对数,因此可以训练学生在回归式损失下重现老师的 reinforcement learning 5-级分数.该方法受到乐观奖励估计和KL规范化策略改进的激发.由于这个目的可应用于累积经验,这篇论文认为它为LLM蒸.带来了基于价值的RL的一个核心优势.理论分析建立了一个理想化的优化公式的逻辑逆向KL遗憾,这意味着相对于简化设置中,教师的累积差距以逻辑而不是线性增长.
最新结果:六个基准,三个设置和四分之一的推出批次
报道的评估涵盖了六个数学推理基准和三个教师-学生设置.在这些比较中,LSPD提高了推理性能和多样本解决方案覆盖率. 多样本解決方案覆蓋率指的是当模型绘制几个答案而不是单一响应时代表了多少正确或有用的解决方案空间.基于重复播放的变体LSPD-RB以约四分之一的部署批次实现了与香草OPD相似的性能.这个数字是该工作中最可见的操作数量:部署集是由学生模型生成的尝试,并且减少它们可以降低收集教师反所需的计算.
蒸的后果
更广泛的信息是,将蒸.视为RL问题开启了超出政策梯度的算法选择.对于跟踪LLM培训成本的读者来说,这意味着教师-学生学习不必保持一次更新循环中的一个样本.一旦目标被表达为KL规范化的RL,可以对标准策略梯度配方进行重复测试,乐观估计和最小平方回归等基于价值的想法,从而创造与老师每次互动的更多机会.LSPD和LSPD-RB目前作为数学推理任务评估的研究方法而不是所有蒸管道的最终替代品.接下来的优势是是否可以在没有损失样本效率的情况下将相同的最小方形视图传递到这些基准设置之外.
Comments
No comments yet. Be the first to comment.