
V-CoLA:使用线性注意力压缩视觉 tokens
在没有训练的情况下,V-CoLA在线性注意力飞行器中压缩视觉 tokens ,保持精度和加快预填充.
关键点
- V-CoLA针对使用线性注意力的混合VLM进行视觉 token 压缩,而基于softmax的压缩方法通常会失败,因为它们依赖于完全关注重量.
- 它不需要培训,并直接从循环状态使用基于最终状态贡献和短期状态变化的独特性意识标准来评分视觉 tokens .
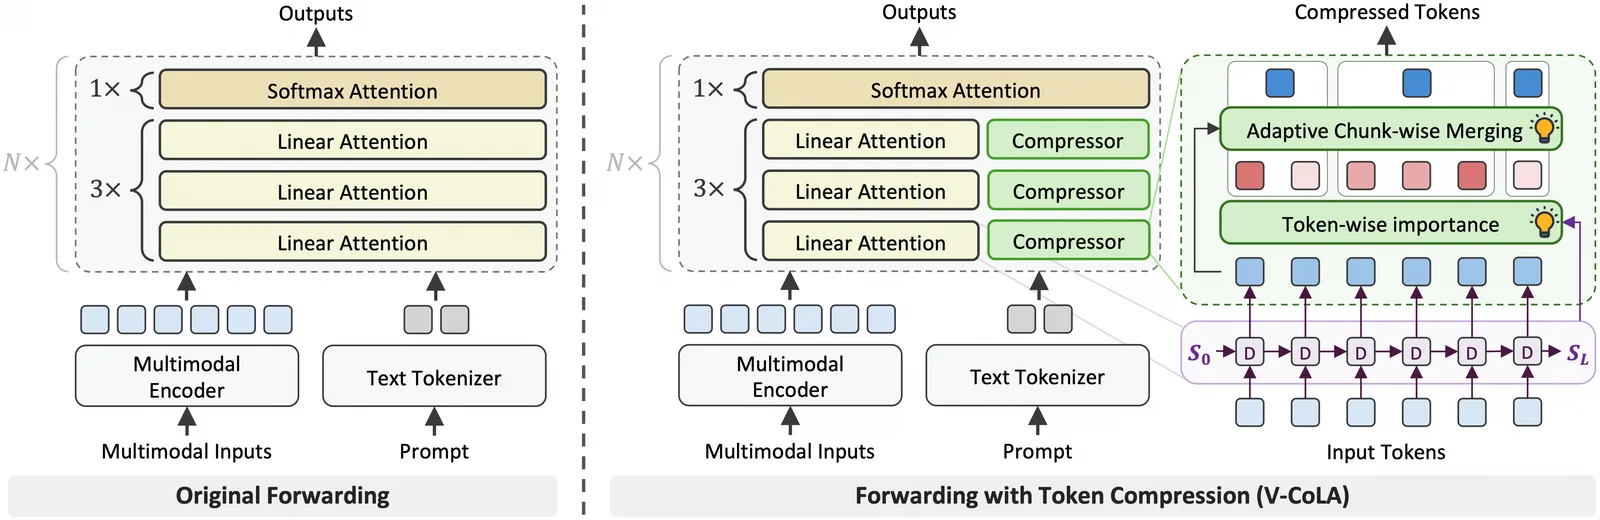
- 它可以自适应地合并重要的 token 块,并在更深层中丢弃冗余的 tokens ,同时保持与块智平行内核的兼容性.
- 它保持了 99.5% token 预算和 88% 在 12.5% 的性能,同时实现 1.86 speed6.15×预填充加快.
视觉语言模型 (VLM) 已成为混合图像和文本任务的标准架构,但它们的推断成本尺度与视觉数 tokens 被输入到模型中.一个名为 V-CoLA 的新框架,缩写为 Vision Token Compression for Linear Attention,针对现有压缩方法留下的空白:基于线性注意力的混合VLM,例如Qwen3.5.
背景:为什么基于软max的压缩失败
大多数视觉 token 压缩技术假定软max注意力.他们通过检查关注重量来估计 token 的重要性,然后相应地修剪或合并 tokens .这种假设在线性注意力架构中会崩,其中模型带有反复状态而不是完全的注意力矩阵.因此,为软max 注意力开发的方法很难转移到混合VLM,该结构将线性的注意力与其他机制混在一起.
如何使用V-CoLA
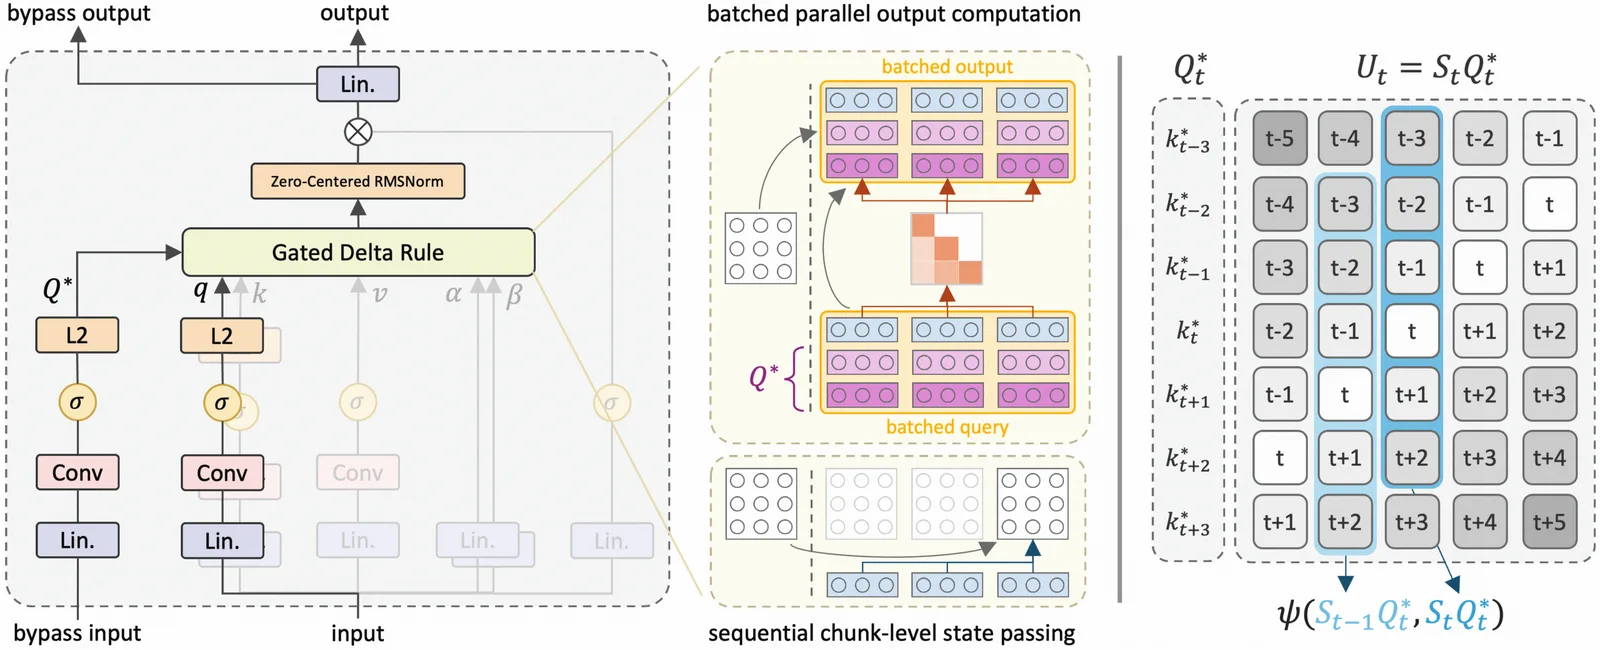
V-CoLA是无训练的,这意味着它不需要 fine-tuning 或基础模型的重新培训. 它使用唯一性意识标准直接从反复状态对每个视觉 token 进行评分. 该标准结合了两个信号: token 在最终状态中贡献多少,以及短期内改变该状态的程度.
根据这些分数, tokens 被适应性地合并为块,其形状遵循重点集中的地方.在更深层中,冗余的视觉 tokens 被彻底删除.每个组件都与块智平行内核保持兼容,这对现有 hardware 的实际部署很重要.
性能和速度
报告的结果值得注意的是,该方法不添加任何训练.V-CoLA在保持视力 tokens 时保留了 99.5%原始性能.即使是在激进的 12.5% token 预算下,它也超过 88% 原始性能的效率方面,它提供 1.86 speed 6.15×预填充速度.
预填充阶段是模型在生成输出之前处理输入的过程,并且它通常是长视觉输出的瓶.减少视力 tokens 直接降低了成本.
需要注意什么
结果表明,随着混合和线性注意力VLM的传播,针对软max关注的压缩研究并不是故事的结束. V-CoLA的收益是否在Qwen3.5以外的其他线性关注架构中保持,以及它如何与生产内核中的不同块大小相互作用是值得跟踪的开放问题.对于运行视觉工作负载在线性 注意力模型上的团队来说,该框架提供了一条降低预填充成本而无需重新培训的途径.
Comments
No comments yet. Be the first to comment.