
具有程序验证的自进化的视觉语言模型
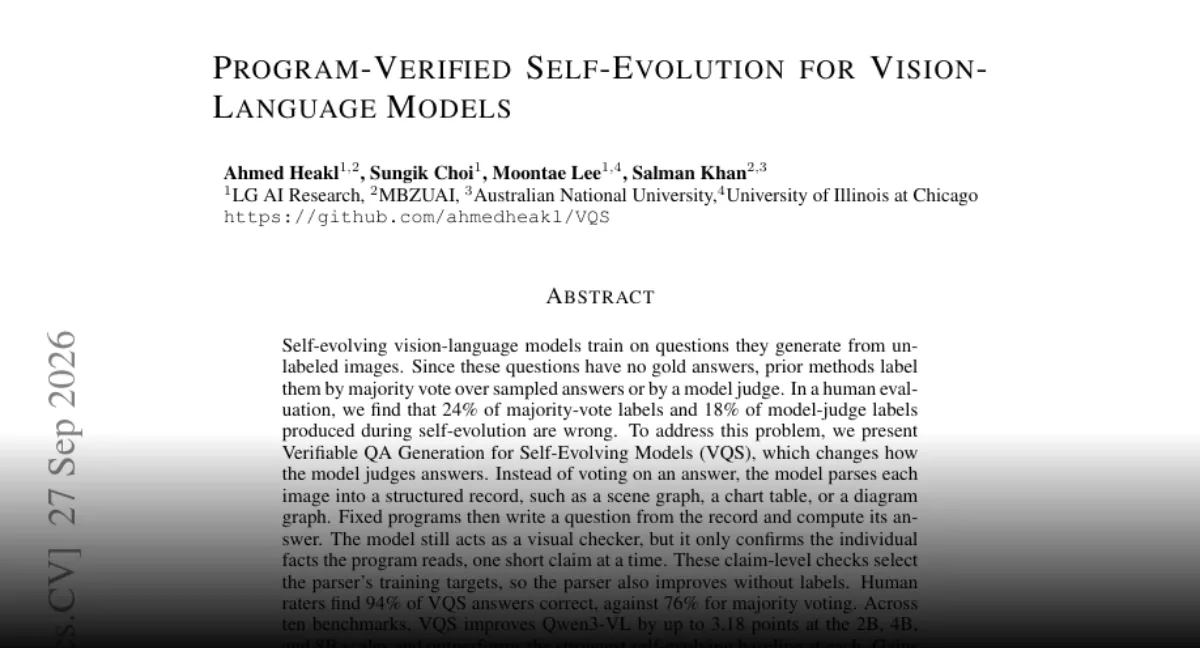
通过结构化图像记录和程序计算的答案,VQS减少了VLM标签噪声,在10个基准值上提高了Qwen3-VL高达3.18分.
主要内容摘要
- VQS在自我演变的视觉语言培训中解决了噪音自生成标签,其中多数投票和模型评审者标签的人类检查错误率为 24% 和 18%.
- 它将图像转换为结构化记录,然后使用固定的程序来生成问题并计算答案,从而提高了对多数投票的正确性.
- 当用于训练 Qwen3-VL 时, VQS 在10个基准测试中提高了高达 3.18 分的性能 2B, 4B 和 8B.
- 较小的模型受益特别强烈,在三个轮之后获得了高达 3.84 分的优势 2B,表明更清洁的结构化监督可以跨模拟尺寸进行扩展.
首选图片: 在线视频, 下载地址: http://www. 有几何形状,梯度和网络节点的抽象技术风格; 没有真实的人,
标签描述: 字体的类型是什么? (Meta description) VQS在自我发展的视觉语言培训中减少了标签错误,并将 Qwen3-VL 提高到 3.18 分.
VQS针对自我演变的视觉语言模型中的一个弱环:他们为自己创建的标签.这些模型从未被标记的图像中生成的问题上学习,但人类检查显示 24% 的多数投票标签和 18% 模型评审标签是不正确的.通过使图像对问题过程更加结构化,VQS将答案正确性提高到 94% ,与 76% 相比对于大多数投票,并在 2B , 4B 和 8B 中在十个基准点内改善了 Qwen3-VL 高达 3.18 分.
背景:自创的标签成为培训瓶
视觉语言模型将图像与语言结合起来,因此 training data 经常需要配对的问题和答案.自演化的方法试图通过要求模型检查未标记的图像,创建问题,然后赋予标签来减少手动标注.多数投票使用重复的模型输出来选择共识回答.模型判断使用模型本身或另一个模型来得分候选人的答案 .这两种方法都使训练具有可扩展性,但它们也可以在规模上教导错误.人为验证的错误率,24%对于大多数票标签和 18%用于模型评审标签,解释了为什么更好的标签构造很重要:如果培训信号是杂的,以后的模型更新会继承这种噪音.
开发过程:VQS将每个图像转化为结构化的记录
VQS改变了序列.而不是要求模型直接从图像中发明一个完整的问答对,该模型首先将每个图像转换为结构化记录.来源描述这种记录就像场景图或图表一样.场景圖捕获视觉场景中的物体和关系,而图表则将图表或表格中显示的值组织成行和列.
在记录存在后,固定的程序会写出问题并计算他们的答案.模型不被要求自由创建事实.它只能一次确认简单的事实.这种分离很重要,因为程序可以强制执行一致性:一旦图像作为数据表示出来,问题和答案就可以从该数据中生成而不是来自未经验证的猜测.报告结果是 94% 正确的答案,与 76% 大多数投票相比.
最新进展:Qwen3-VL在 2B, 4B 和 8B 的增长
该方法的实用价值出现在它用于训练视觉语言模型Qwen3-VL时.在十个基准标准中,VQS在 2B, 4B 和 8B 尺寸上提高了高达 3.18 分的 Qwen3 - VL . 它还击败了报告中的每一个尺寸的最佳自我进化基线.经过三轮培训后最强 gain的报道是 3.84 点 2B .
尺寸模式值得注意.较小的模型通常从清洁器 training data 中获益更多,因为它们在噪音监督下恢复的能力更低. 在 2B,经过三轮训练后的结果是 3.84 分,表明重复循环可以增加收益. 在 4B 和 8B,收益保持到 3.18 分,这表明该方法不仅限于最小的模型大小.
当前阶段:自主发展培训的更清晰路径
当前阶段并不是一个一般的说法,即自我进化的训练是解决的.它是一个更狭窄的结果:当问题以结构化图像记录为基础,答案由固定的程序计算时,标签噪声下降和模型性能上升.对于追踪视觉语言模型培训的读者来说,关键信号是VQS通过一种工作流程连接了两个问题 - 标记可靠性和基准改进. 下一个问题是相同的结构化记录机制是否可以在更多的图像类型,更多的程序模板和更多的训练轮中扩展而不会放弃其精度优势.
标签:VQS, Qwen3-VL,视觉语言模型,自我发展的培训,AI基准
Comments
No comments yet. Be the first to comment.