
测试镜:在单一参考之外重新构想测试评估
TestPrism显示了严格的多候选人测试差距;TestHelix通过修复对,交叉验证和自我改进来提高分数.
主要内容
- TestPrism为LLM生成的测试引入了更严格的评估标准,要求它们通过所有有效实现并失败所有的无效实现,而不是仅与单个参考解决方案进行检查.
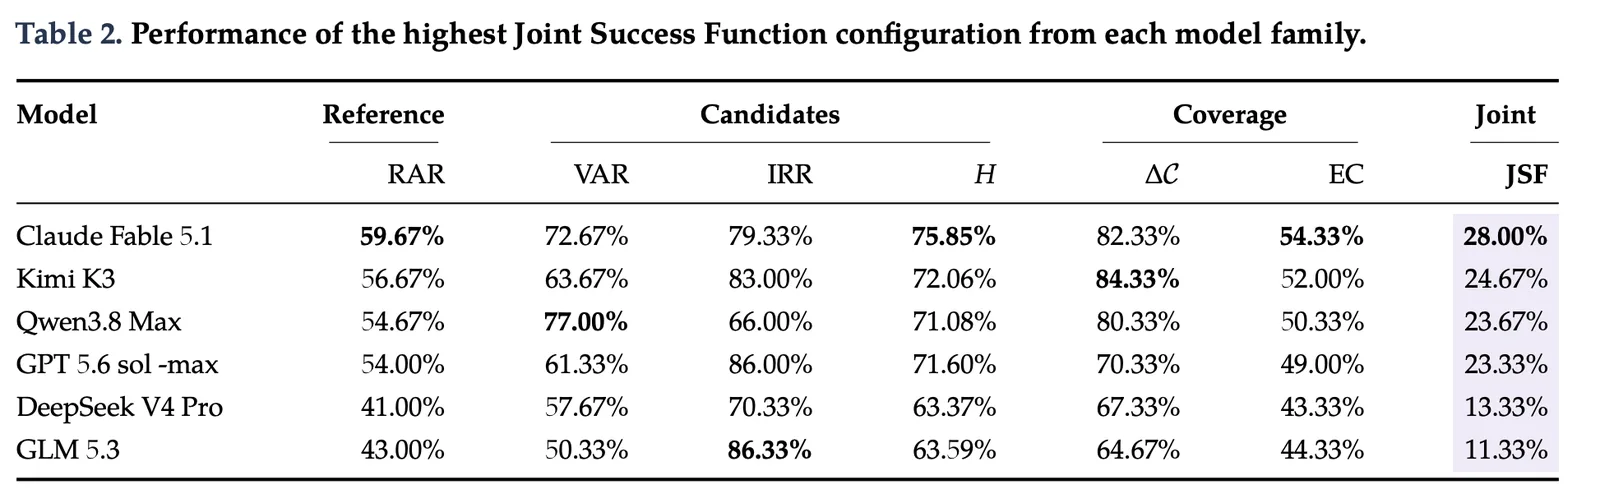
- Under TestPrism 89sJoint Success Function指标,基线编码剂只能达到28.00%,而单一参考评价的59.67%,显示许多测试似乎可靠,但实际上不完整或脆弱.
- 测试失败主要来自缺少的行为,未得到支持的断言和错误的测试构建,这可能会对自动化编码工作流产生虚假信心.
- TestHelix通过结合测试合成,修复候选项,同行交叉验证和递归自我改进来解决这些弱点,比基线.带提高了Joint Success Function分数的8.67到9.00个百分点.
标签描述: (中文) 字体: ... " . " " " TestPrism显示LLM编码剂测试在严格的指标上仅通过了28.00%,而TestHelix则在新的基准中将得分提高到8.67至9.00点.
标签: 一个字母,一个字符号. . . . ,. 编码剂, 自动化测试
首选图片: 在线视频, 下载地址: http://www. 抽象技术插图显示代码测试,程序状态和验证路径,没有人,标志或文本.
背景:TestPrism之前的测试生成问题
LLM编码代理,即生成和评估代码的大型语言模型系统,在各种编程任务中具有先进的测试生成.常见做法是对单个参考解决方案进行生成测试的评价.这种方法将一个正确实现视为整个规范,即使许多有效实施可以满足同样的任务.当测试套件仅由该解决方案来判断时,它可能看起来比实际情况更可靠,因为它可能错过了边缘案例,替代行为或应该失败的无效程序.
发展:TestPrism将测试置于更严格的联合标准之下
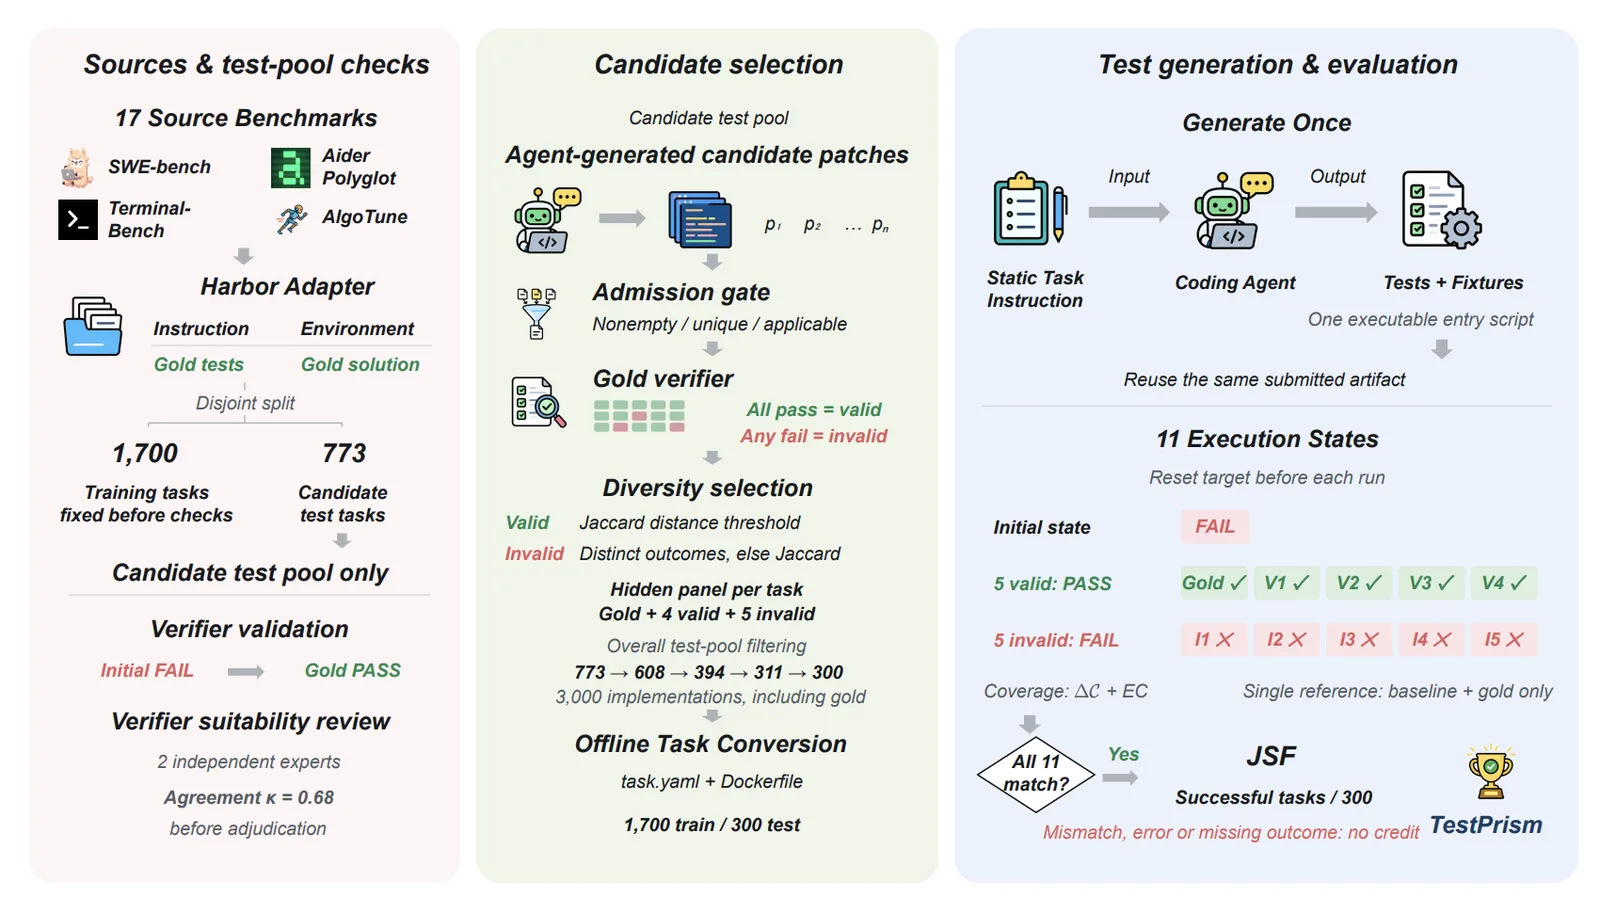
TestPrism是为了测量这个盲点而推出的.它包括来自17个源的300个测试任务和3000个候选实现,均分为有效和无效解决方案.它的主要指标是Joint Success Function.一个生成的测试套件必须在初始程序状态上失败,接受每个有效候选者并拒绝每位无效候选人.
在14个基线编码代理配置中,Joint Success Function仅达到28.00%,而单一参考成功达到了59.67%.这个差距表明在一个引用下看起来有用的测试可能仍然不完整或易碎当暴露于更广泛的一组实现.
分析:为什么严格考试成绩仍然很低
结果指出了三种失败模式.生成的测试可以错过行为,这意味着它们不会检查程序中区分正确与不正确实现的部分.它们可能包含未得到支持的断言,这些是关于测试环境或代码不证明的程序行为的说法.它们也可以反映出有缺陷的测验构建,例如受损的检查或使测试变得不稳定的假设.
这些弱点对读者来说很重要,因为编码代理通常用于加速开发工作流程.如果测试套件太简单或太狭窄,它可能会产生错误的信心.一个通过参考解决方案不足以证明测试组件可以保护真实行为.
最新进展:TestHelix试图更注重维修的工作流程
为了解决弱点,该研究引入了TestHelix.它结合了测试和修复对的异质合成与同行交叉验证和递归自我改进 (简称RSI). 该方法旨在产生不仅是测试,而且还可以修复候选者,然后使用交叉认证来检查生成的测试是否区分有效行为和无效行为.
在TestHelix评估中,在两个模型中,测试螺旋环比原生.带对照器提高了Joint Success Function的8.67到Under TestPrism个百分点.这种改进不是一个完整的解决方案,但它表明结构化的自我检查可以提升性能超出简单的基线.带.
接下来要看什么
目前的证据将自动化测试生成置于两个阶段之间.早期系统使得快速创建测试草稿变得实用.TestPrism表明,更严格的评估仍然会发现大差距. TestHelix显示了一个可能的方向:在同一循环中结合测试合成,修复,交叉验证和自我改进.
对于遵循LLM编码代理的读者来说,关键问题不再是某个代理能否通过一个参考解决方案进行测试.而是这些测试在考虑许多候选程序时是否仍然有效. 28.00%和Joint Success Function结果,以及TestHelix获得的8.67到9.00百分点收益一起表明可靠的测试生成仍是一个开放式工程问题.
Comments
No comments yet. Be the first to comment.