
在文本中 robot 让学习可访问:操纵任务的简单配方
一项新的研究通过定义四个语义目标来澄清 robots 应该从视频演示中学到什么:动作,对象,构成和负担能力.它介绍了一个低成本的数据配方和一个极简化的视觉提示编码器,避免了大规模的预训练.在模拟和八种现实任务中的实验显示出强大的零射击概括性和稳定性.完整的数据和培训管道将是开源的,以支持可重复性和未来的 robot 学习研究.
关键点
- 这项研究解决了 robot 在语境学习中的一个关键模两可: robots 实际上应该从视频演示中效仿什么.
- 它通过四个语义层面来定义学习目标:动作,对象,构成和负担能力.
- 引入了低成本的数据配方和简约的视觉提示编码器,避免大量预训练并减少计算需求.
- 在模拟和八个现实任务中的实验显示出强大的零射击概括性和稳定性.
- 数据和培训管道将完全是开源的,以支持可重复性和未来发展.
标题: 一个小说的故事. . . . , . . ! . robots 实际上从视频演示中学到的东西:一种新的背景学习方式
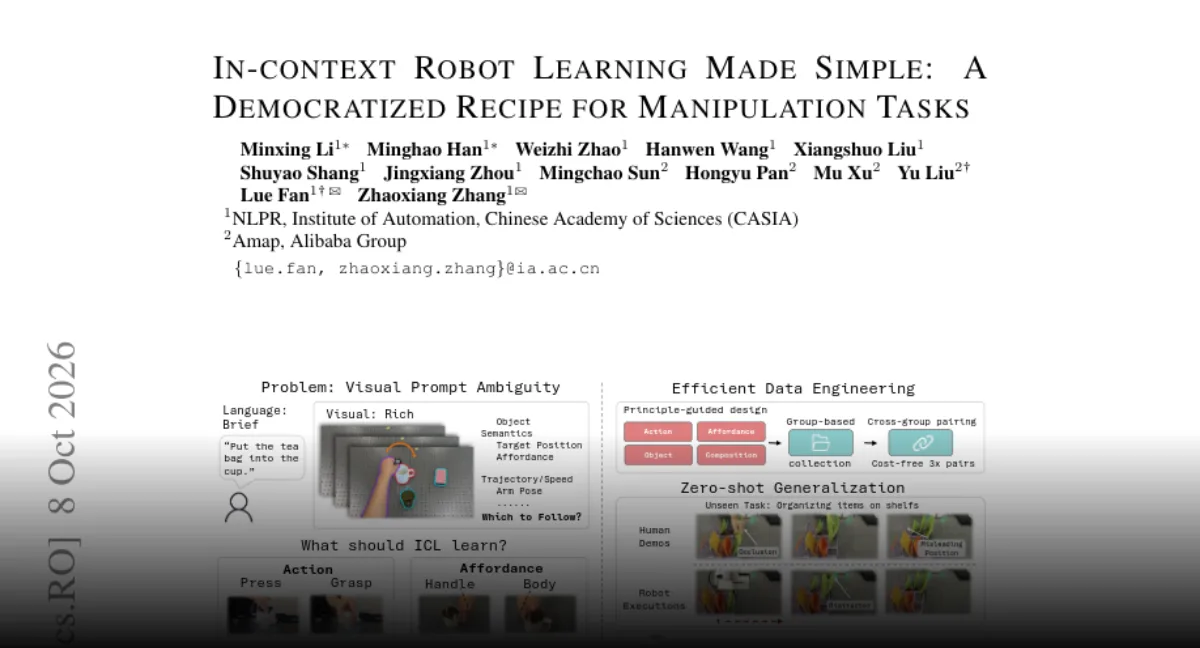
:不含任何其他物质. (C) . (D) 一项新的研究努力正在解决 robot 在语境学习中的核心模两可:当一个 open-source 4观看视频演示时,它应该确切地模仿什么?这项工作定义了四个语义层面的学习目标 - 动作,对象,构成和负担能力 - 并将该定义与低成本数据配方和简约化的视觉提示编码器相结合,避免大规模预训练. 在模拟和八种现实任务上的实验显示出强大的零射击概括性和稳定性,并且数据和培训管道将完全是开源的.
背景:模糊性阻碍了学习 robot
robot 的上下文学习承诺一个简单的界面:向 robot 展示视频,它就会执行任务.在实践中,视频演示包含了许多信号 - 手臂如何移动,哪个对象被操纵,部分如何组合以及该对象提供什么.如果没有明确的学习目标定义, robot 可能会复制不相关的细节或完全错过意图.这种模糊性使得很难比较方法并知道模型实际上学到了什么.
发展:确定目标,然后为此而努力
这项工作通过在动作,对象,构成和负担能力语义上指定学习目标来解决这个问题.每个级别都捕捉到了演示的不同方面,从低层次运动到对象的功能理解.为了支持这一目标,作者介绍了一种廉价的数据配方和极简化的视觉提示编码器. 编译器是没有大量预训练而设计的,降低了进入障碍并减少计算要求.实验包括模拟和八个现实任务,测试零射击概括性和稳定性.
最新进展:开源管道
数据和培训管道将完全是开源的.这对于可重复性以及希望在不重新创建 dataset 或培训堆的情况下建立该方法的团队来说很重要.
它的含义以及注意事项
主要贡献是概念的清晰度加上实用的配方.通过将动作,对象,构成和负担能力语义分开,这项工作为评估 robot 从视频中学到的东西提供了词汇. 开源承诺是下一个值得关注的里程碑,因为它会让其他人在新任务和 hardware 上测试方法 .
标签描述: 字体的类型是什么? (Meta description) 新的 robot 上下文学习研究定义了 robots 应该从动作,对象,构成和负担能力方面的视频演示中学到什么,使用开源数据和培训.
标签: 一个字母,一个字符号. (TG) " robot 学习, 在语境学习, 视频演示
Comments
No comments yet. Be the first to comment.