
large language models 可以理解顺序结构吗?对推断和生成进行控制的检查
控制的arXiv研究表明 LLMs 可以识别序列策略,但往往无法模拟它们,暴露了代理评估中的差距.
主要内容
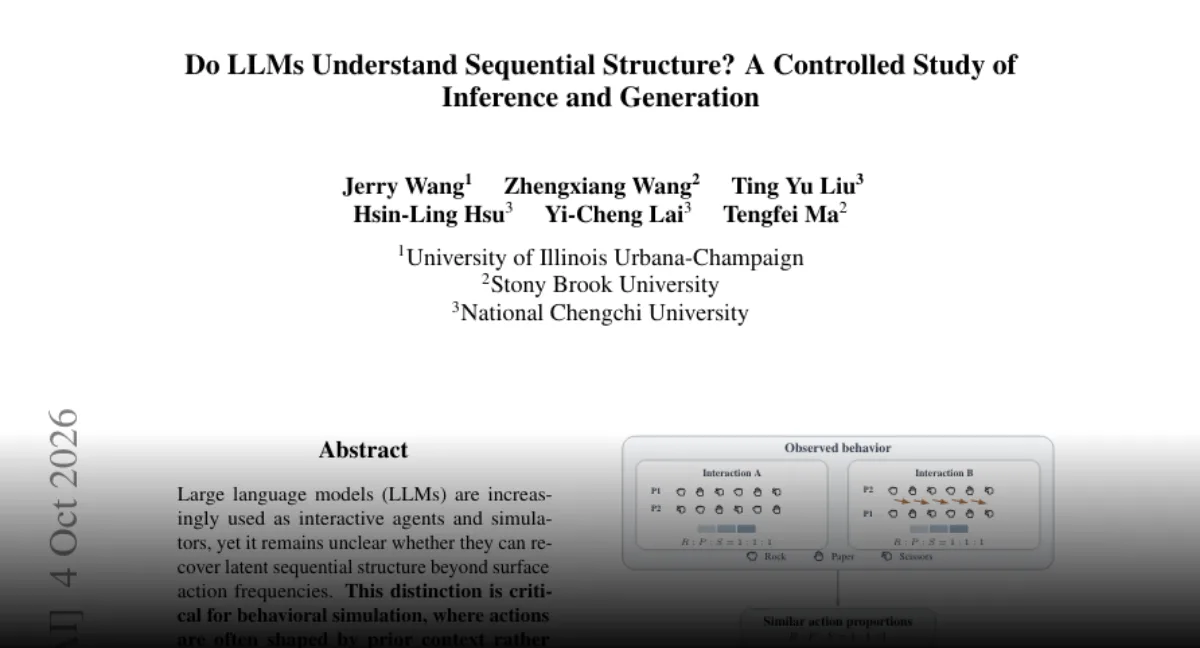
- 一项受控的arXiv研究检查了 large language models 是否真正理解顺序行为,或者仅仅是复制表面模式.
- 这项研究测试了三种能力水平:战略识别,马尔科夫式规则遵循和处理更高阶的顺序依赖.
- 在识别行为策略与通过正确的序列生成忠实地模拟它之间存在关键差距.
- 较长的上下文不一定会改善顺序理解,类似的动作分布可以隐藏错误的潜在生成机制.
- 这些发现表明,评估 LLMs 作为交互剂需要测试隐藏的生成逻辑,而不是 JUST 可观测输出.
标签描述: 字体的类型是什么? (Meta description) 一项受控的arXiv研究发现 LLMs 可能识别行为策略但未能模拟它们,这挑战了交互代理人的评估方式.
标签: 一个字母,一个字符号. (TG) " 互动代理人, arXiv研究
![抽象的顺序决策节点和概率路径在一个 neural network ]
一项受控的arXiv研究,被列为2610.04977,提出了一个看似简单的问题: large language models 是否真正理解顺序行为,或者它们只是复制表面模式? 答案很重要,因为LLM的顺序行为的不再是一个利基标准问题. 它是玩游戏,管理工作流程,与用户互动和随着时间推移充当代理人的系统的基础.
背景:从模式匹配到代理模拟
多年来,语言模型主要是根据它们接下来的输出进行评估.如果下一个单词,动作或行为看起来合理,则该模型被视为有能力的.这种评价方法适用于文本完成,但当模型作为行为模拟器时变得更加危险.模拟机不应该仅仅产生一系列行动;它应该重现生成这一序列的过程.
这篇论文将这一问题置于三个受控实验中.第一项涉及战略识别,其中测试一个模型是否可以识别行为策略.第二项使用马尔科夫规则遵循. 马尔柯夫指的是下一步行动取决于当前状态而不是整个过去的过程.第三项检查了更高阶顺序依赖性,其中未来行为的依赖关系是比单个状态过渡更加复杂的上下文链条.
开发:探测策略,马尔科夫规则和依赖关系
调查的时间表从简单的识别移动到更难的模拟.在战略确定阶段,模型可能能够根据观察到的行为命名或推断一项策略.这是一个描述性的能力.它告诉评估者模型可以检测什么.
马尔科夫阶段测试一种更具机械性的能力:模型能否遵循状态到状态的过渡规则?在这里,问题不在于模型是否可以总结一个模式,而是它是否能够根据将一个状态与下一个状态联系起来的规则生成行为.高级依赖性测试进一步提高了难度.它们检查模型是否能够处理正确的下一步动作取决于多个先前状态或较长的结构关系的序列.
在这些实验中,研究发现了分裂. 识别并不能自动成为忠实的模拟. 一个模型可能会确定它观察到的策略,但仍然无法使用正确的底层序列逻辑来生成操作.
最新进展:识别与模拟之间的差距
核心结果是识别策略和忠实模拟它之间的关键差距.这篇论文还报告了一个反直觉的观点:更长的背景并不一定有帮助.更多的历史不保证更好的顺序理解.在某些情况下,额外的环境可能无法提高模型遵循产生行为隐藏规则的能力.
关于动作分布的发现对于评估尤为重要.两个系统可以在使用根本不同的生成机制时产生类似的动作分配.一个分布匹配可以使模型看起来行为准确,即使其内部序列跟踪过程是错误的.这意味着仅比较最终动作频率的测试可能会忽略严重的模拟错误.
这项研究挑战了 LLMs 如何被评估为行为模拟器和交互代理.如果一个模型可以在不复制因果序列的情况下模仿行为的表面统计数据,那么仅基于输出的基准得分可能会夸大其实际能力.
目前阶段:为什么会发生变化
这篇论文在一个有用的检查点上离开了这个领域: LLMs 可能擅长描述模式,但这并不能证明它们可靠地产生这些模式.对于读者来说,实际含义是代理评估需要将可观测行为与隐藏的生成逻辑分开. https://arxiv.org/abs/2610.04977上的论文标志着基准设计被要求测试更多于行动合理性的阶段.
Comments
No comments yet. Be the first to comment.